Intel D270:给大模型更多内存空间的推理卡
Intel 公布 GPU D-series 细节:D270 单卡 160GB 内存,最高可支持 3000 亿参数模型,主打风冷数据中心推理。
当 AI 助手需要阅读一份长文档时,它必须腾出空间来记住正在读的内容。把这个场景乘以几十个同时使用同一服务的用户,内存就成了背后计算机能扛住多少请求的实际瓶颈。
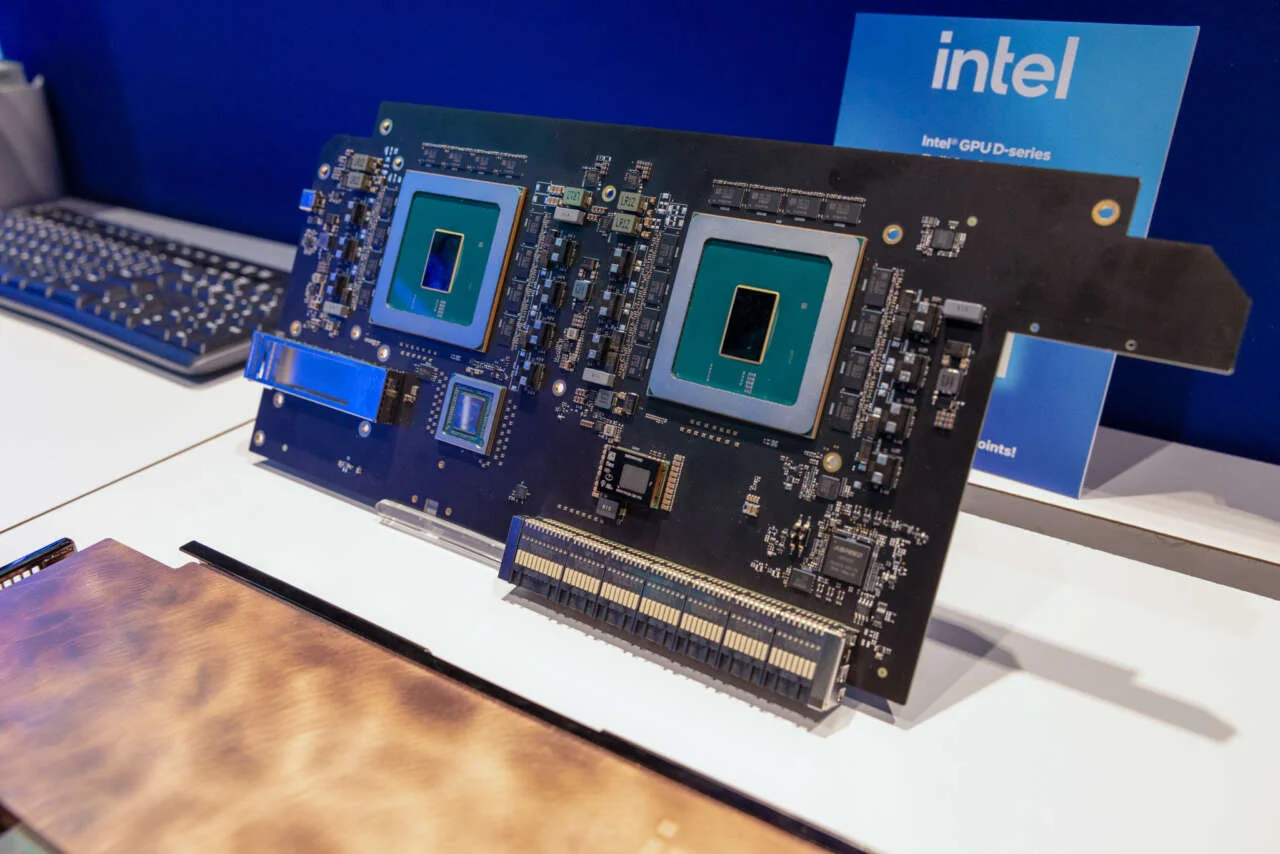
Intel 的 GPU D-series 正是冲着这个问题来的。公司在 10 月 12 日的 Open Compute Project 全球峰会上分享了新细节,其 D270 产品页面描述了一款服务器加速器:围绕大容量内存、普通风冷以及运行 AI 模型的任务而设计。
这就是此前被称为 Crescent Island 的硬件,Intel 在 2025 年 10 月首次公布。本周的更新带来了 D-series 的命名、更多规格,并确认客户送样正在进行。它是数据中心产品,因此与你日常生活的联系,要通过你使用的 AI 服务来体现。
OCP Intel 展台展示。
推理才是 AI 真正干活的部分
训练是 AI 模型从数据中学习模式的过程。推理则是训练好的模型处理新请求时发生的事:总结报告、辅助写代码或生成图片。
可以把训练看作学菜谱,推理则是照着菜谱做菜。一个要处理成千上万请求的服务,必须在学习阶段结束后继续“做菜”。
Intel 设计 D270 就是为了这种重复性工作。其列出的用途包括企业助手、文档处理、编程助手和图像生成模型。公司还强调了 AI 智能体,它们可以在完成一个任务时进行多次模型调用并使用软件工具。
因此,单次请求可能变成多轮读取、处理和回应。硬件既要处理输入,也要产出答案。
大内存数字要分清一件事
Intel 自家的 PCIe 卡配备 160GB LPDDR5X 内存。根据 Intel 公告中的一条脚注,该设计还允许制造合作伙伴打造内存高达 480GB 的卡。
内存为 AI 系统提供了存放模型本身以及处理对话或文档时保留信息的空间。更长的输入和更多同时在线用户会推高这一需求。更大容量有助于把工作留在更少的加速器上,不过实际需求取决于模型及其配置方式。
Intel 表示,该系列单卡可支持最多 3000 亿参数的模型,八块 GPU 合计可支持超过 1 万亿参数。参数是模型在训练中学到的数值。这些数字描述的是 Intel 声称支持的模型规模,并不告诉你答案来得有多快。公告没有说明这些上限背后的具体模型、数值格式或显存配置。
Intel 还列出 1.5 TB/s 的内存带宽,描述数据进出内存的速度。这关乎数据搬运,而不是系统每秒能给出多少条聊天回复。
对运营 AI 服务的人来说,有用的结果是:在选定模型和软件的情况下,系统能以可接受的响应时间完成多少请求。
一张采用风冷的服务器卡
Intel 的 D270 卡属于 GPU D-series,专为数据中心 AI 推理打造。图片:Intel Corporation。
D270 采用 Intel 的 Xe3P 架构和标准 PCIe 5.0 连接。Intel 给出 350 瓦功耗范围和被动风冷设计,由服务器提供气流。
这让部署方案变得直接:把推理硬件放进合适的现有服务器,无需增加专门的液冷系统。350 瓦这个数字指的是加速器本身,不是整台服务器的耗电。
软件也是同一套说辞的一部分。Intel 点名了 PyTorch 和 vLLM——开发者用来构建和提供 AI 应用的工具,并表示 D-series 与自家其他 Xe GPU 共享软件基础。熟悉的工具能减少应用迁移的工作量,而实际性能仍然取决于最终配置。
这对 AI 用户意味着什么
对于使用 AI 助手的读者来说,D270 解释了 AI 硬件竞赛中不那么显眼的一面。长文档、超长对话以及大量用户同时使用服务,产生的需求远超单纯的算力速度。Intel 把内存容量和服务器兼容性放在了答案的中心。
客户送样意味着部分客户正在评估该硬件。Intel 10 月的公告没有提供正式上市时间或定价。实际承诺是:让这些服务所需的模型和对话有更多空间持续运转。


讨论
0 条评论