华硕 ProArt P16 初体验:本地 AI 与创作工作站
一位 Mac 老用户上手华硕 ProArt P16:4K OLED、RTX Spark 本地 AI 实测、CPU/GPU 跑分与创作工作流初体验。
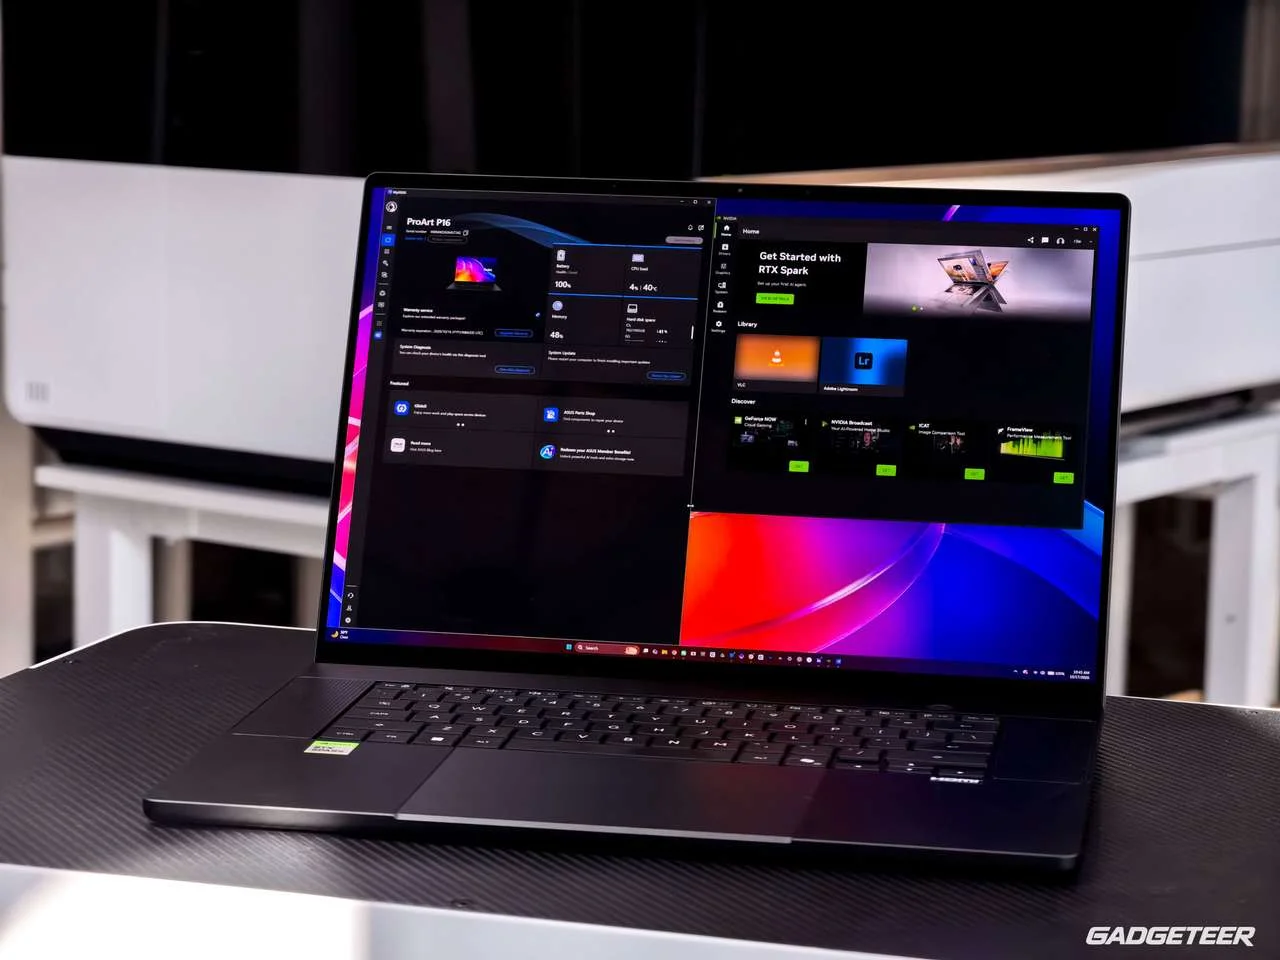
在 Mac 上用了将近 15 年之后,我把华硕 ProArt P16 当作一次换轨测试:这台机器搭载 NVIDIA RTX Spark,目标不是跑分好看,而是能不能把照片、视频、写作和本地 AI 放进同一天的工作流。这次测试从 10 月 15 日开始,到 10 月 16 日已积累约 36 小时使用记录。
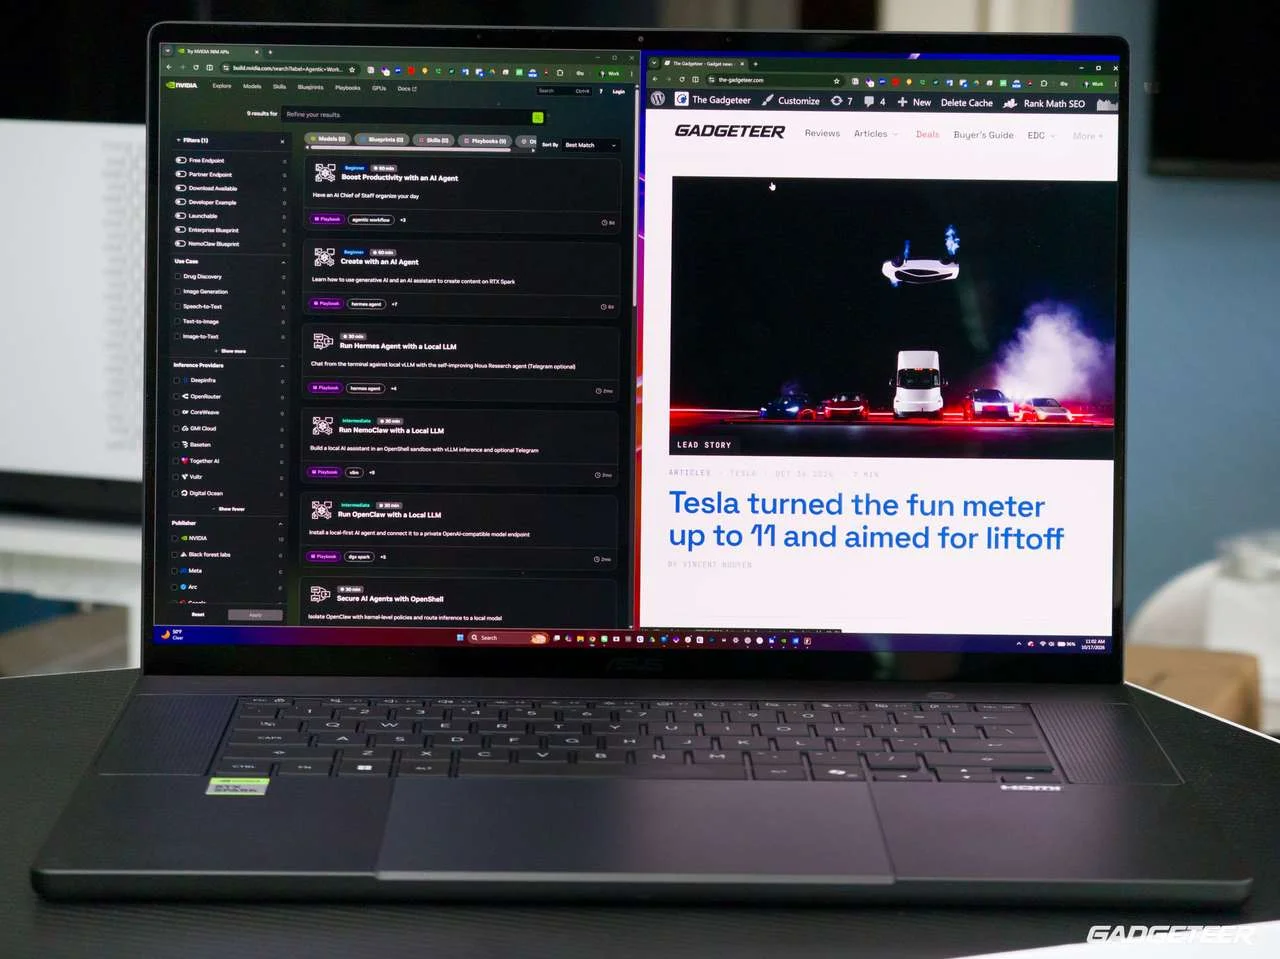
我能在笔记本上跑 AI 模型,但真正的问题是哪些任务可以交给它。糟糕的头脑风暴建议丢掉即可;算错总数,或代我执行某个动作,就可能带来麻烦。速度有用,答案正确才让本地 AI 值得用。
机器与日常设置
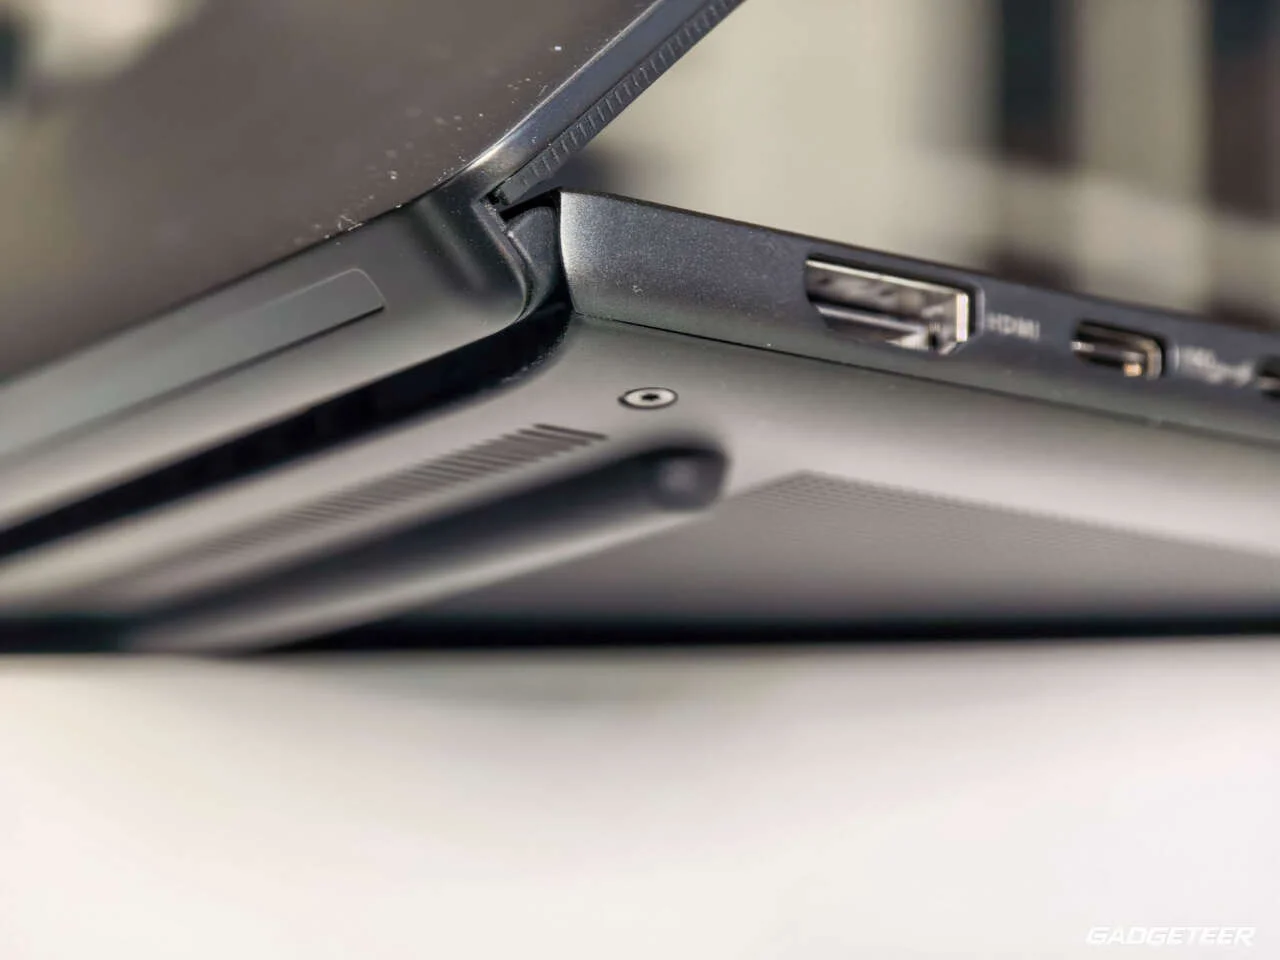
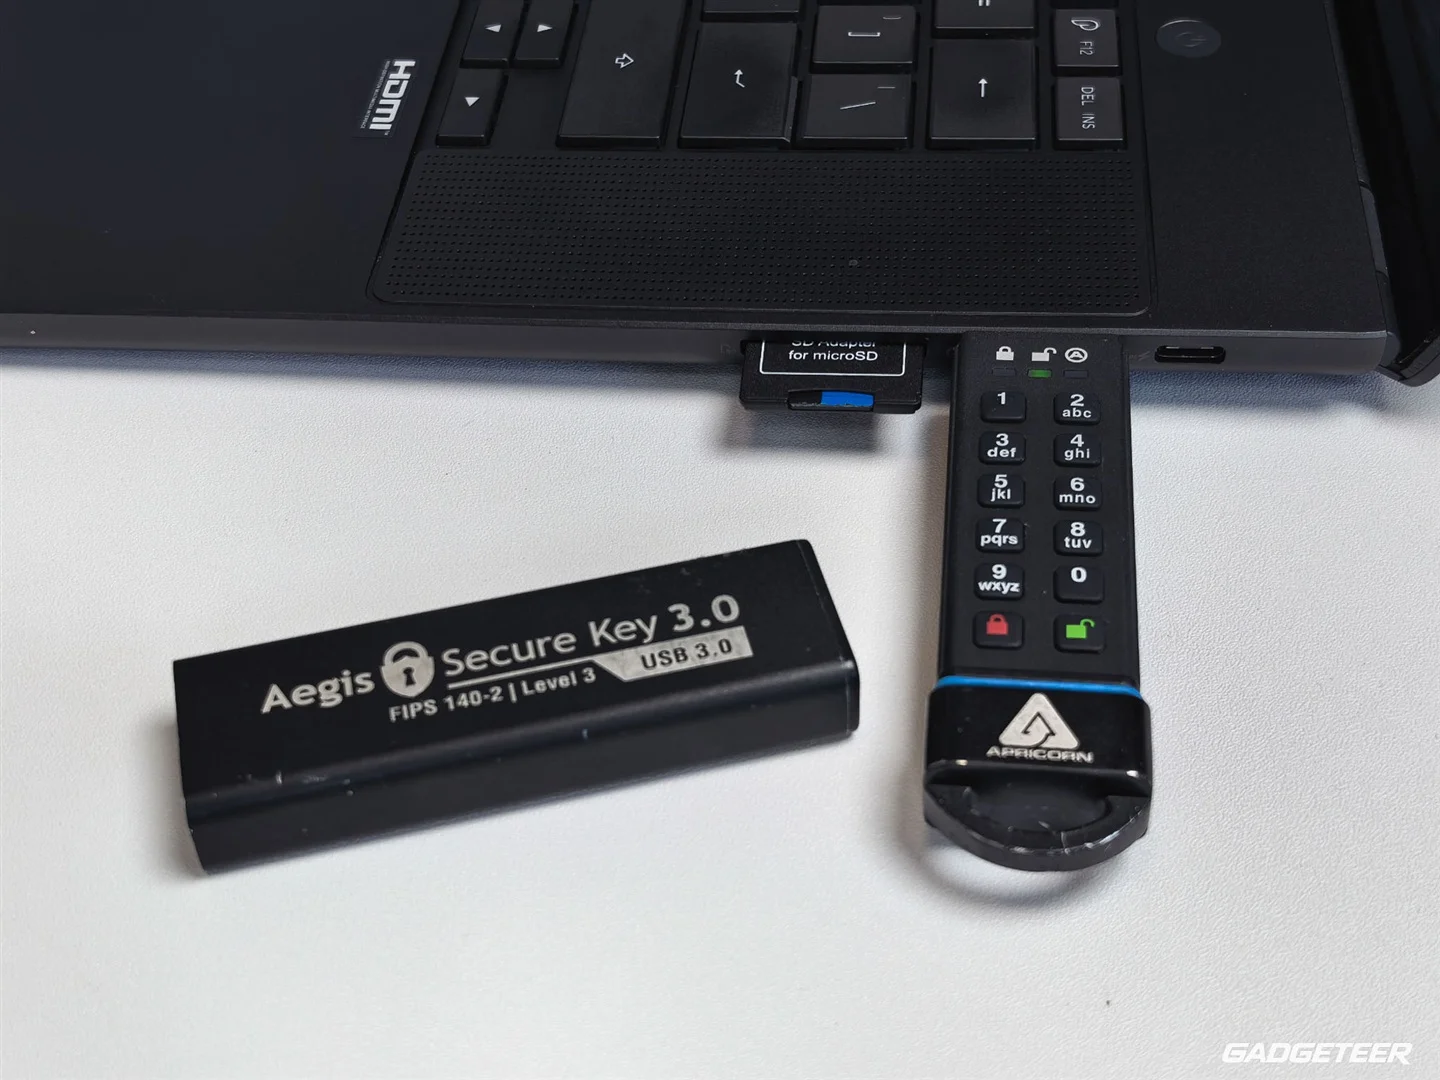
P16 不含充电器重 3.9 磅。机身宽大但握持平衡,键盘和触控板都很好用。接口包括 3 个 USB4、HDMI、USB-A、音频口和全尺寸 SD Express 读卡器;我经常从相机导入照片和视频,包括 Insta360 和 Luna Pro,内置读卡器少带一个配件。
屏幕是 16 英寸 4K ASUS Lumina Pro OLED 触控屏,采用 Tandem OLED,分辨率 3840×2400,刷新率 120Hz。我在 150% 缩放下使用,文字锐利,比之前开始显得拥挤的 14 英寸 Mac 设置能铺开更多工作窗口。16:10 比例在 Lightroom 里给照片和编辑控件都留出了空间。
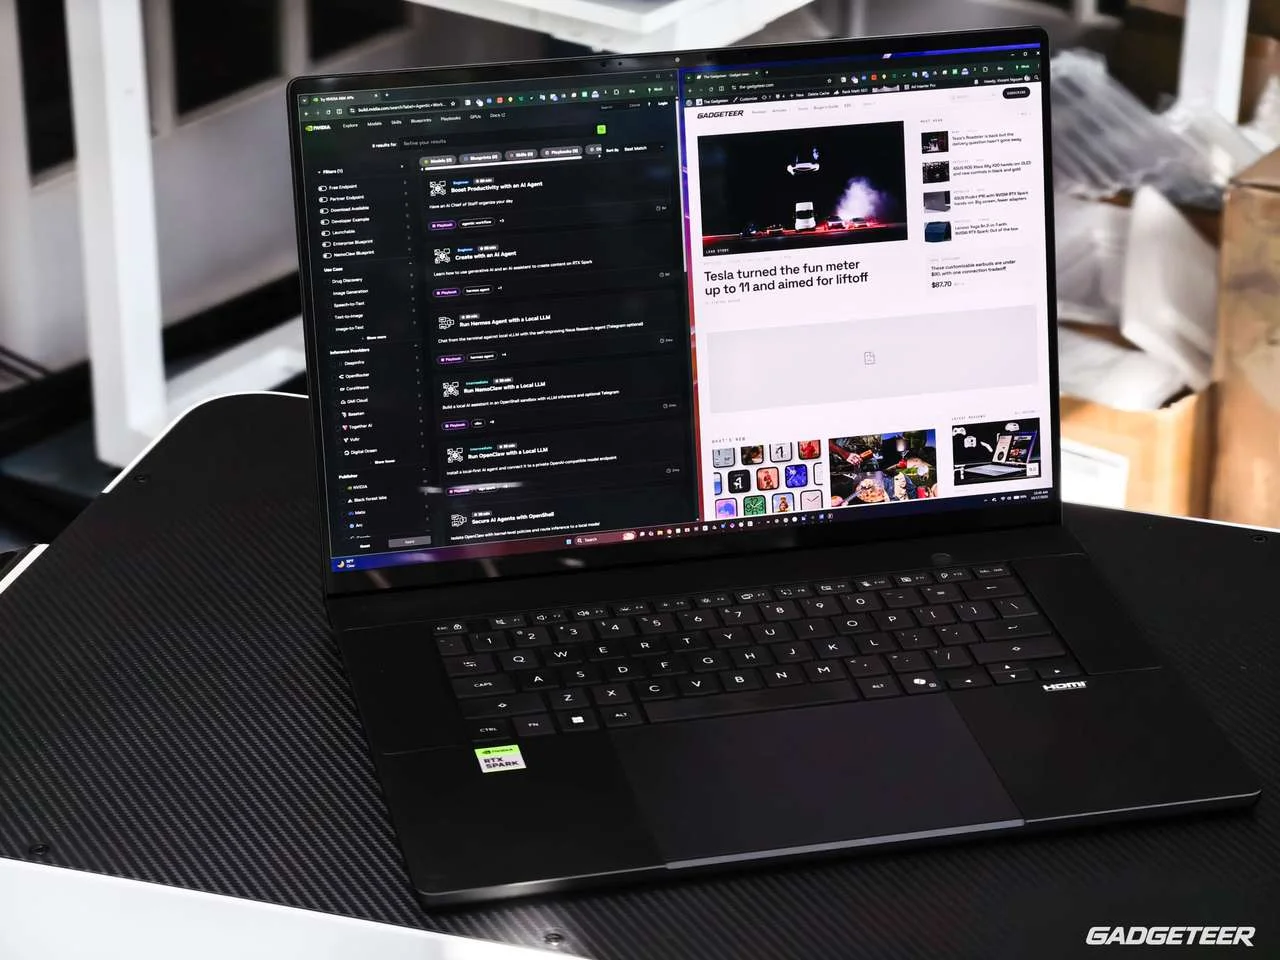
我的工作环境是 Windows 11 Pro ARM64:Lightroom 修图、Insta360 Studio 处理 360 视频、Google Drive 后台同步、Wispr Flow 听写,另外装了 ArtCraft。持续施压时机器仍保持响应,没有明显卡顿或变慢。测试使用 BIOS H7607BA.304 和 NVIDIA 驱动 617.21。
美国起售价 2,799.99 美元,ASUS 列出 10 月 16 日起线上开售。不同零售配置的规格和价格会有差异。
本地 AI 的第一批数字
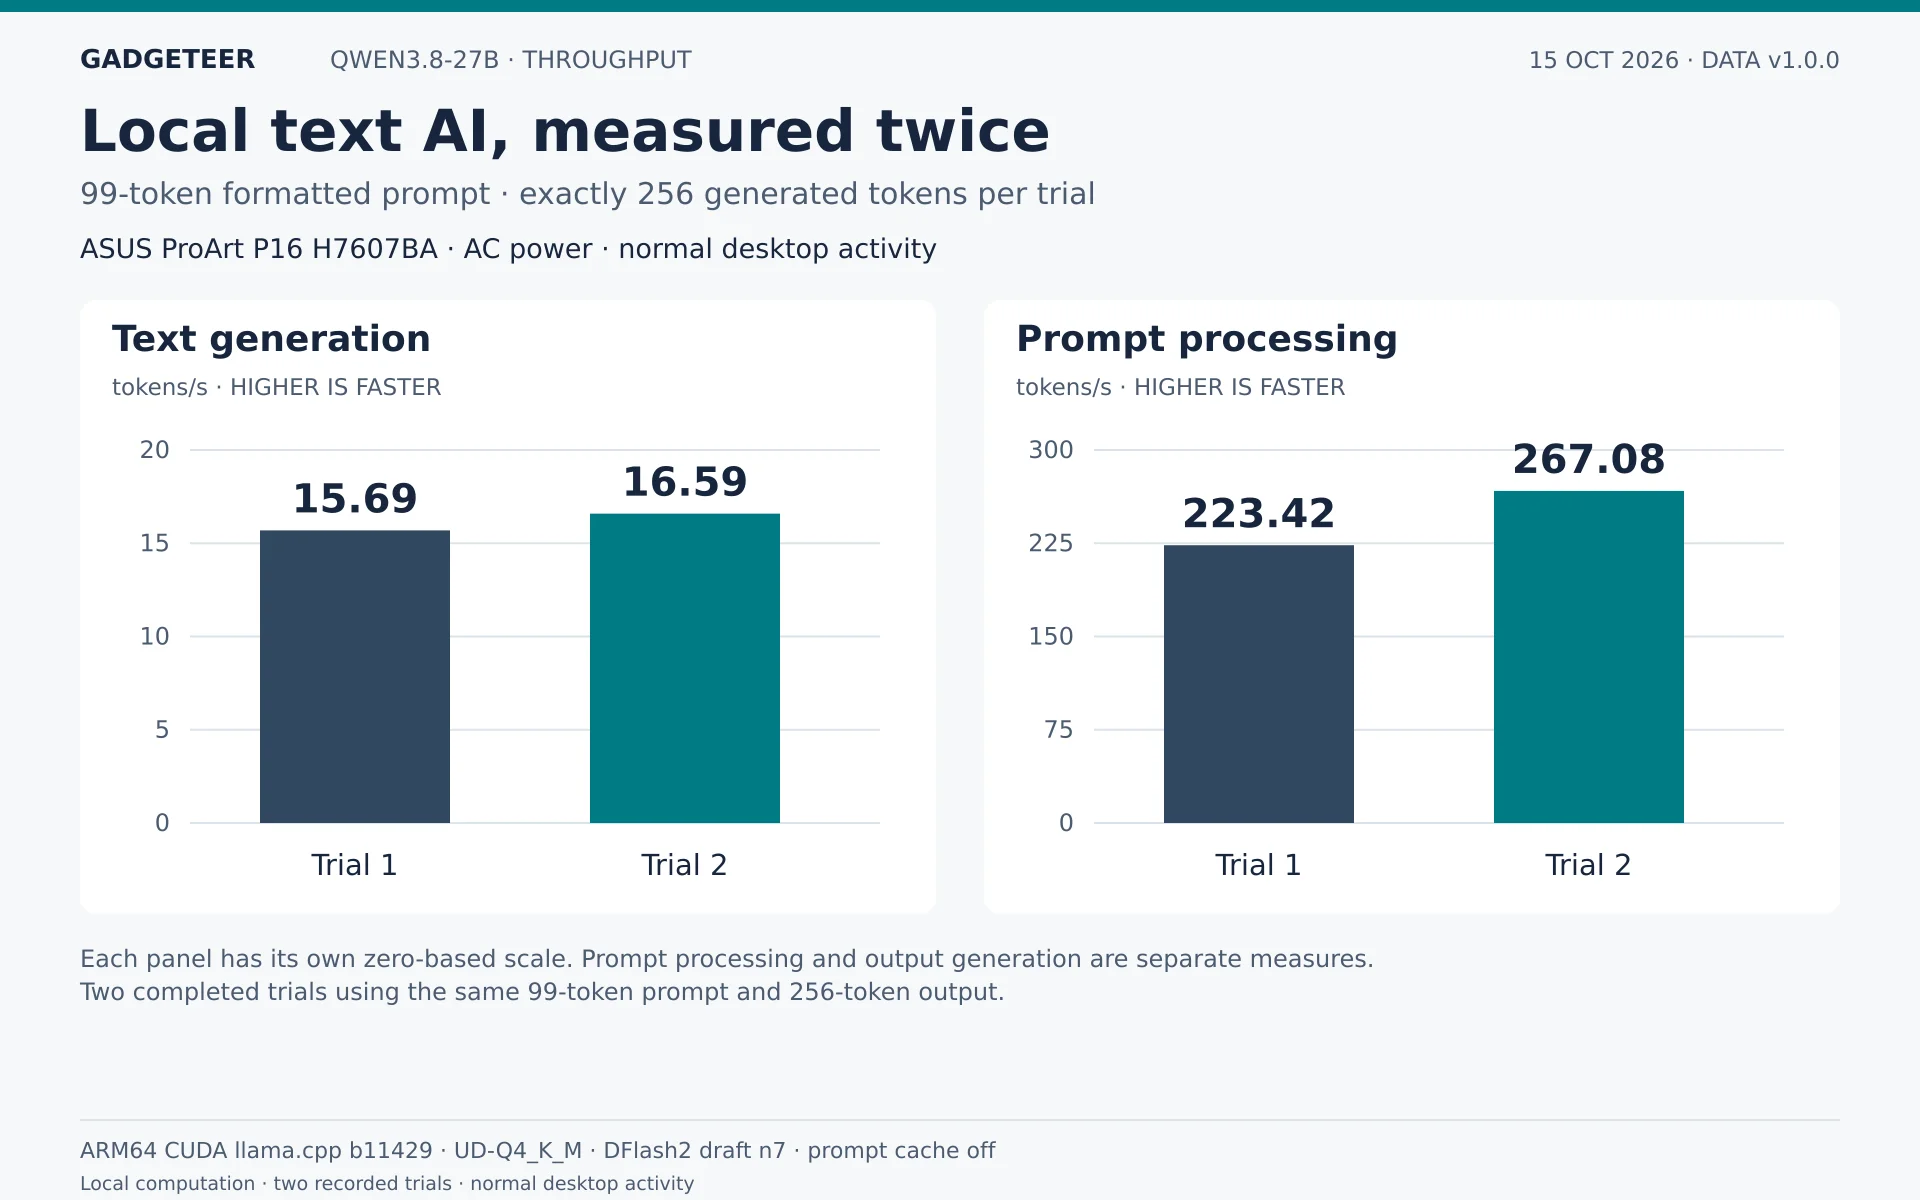
首批测试用原生 ARM64 CUDA 版 llama.cpp b11429,模型为 Qwen3.8-27B UD-Q4_K_M,搭配 DFlash2-Q4_K_M 草稿模型。两轮都使用相同的 99 token 格式化提示,固定生成 256 token,温度 0、相同种子,关闭提示缓存。运行时分配了 262,144 token 上下文,但这是一次短提示测试,并非真的输入了那么长。
第一轮生成 15.69 token/s,第二轮 16.59 token/s;第二轮首个流式内容在 0.446 秒到达。整次请求分别耗时 16.70 秒和 15.82 秒。两份输出都是可读片段,并在指定 token 上限停止。测试时接交流电,桌面和 Drive 正常活动,电源计划记录为 Balanced。
首 token 延迟说明我要等多久才开始看到答案,生成速度说明它写得多快,两者都不能证明答案正确。这里的错误出在模型回答上,没有证据显示是 RTX Spark 造成的。
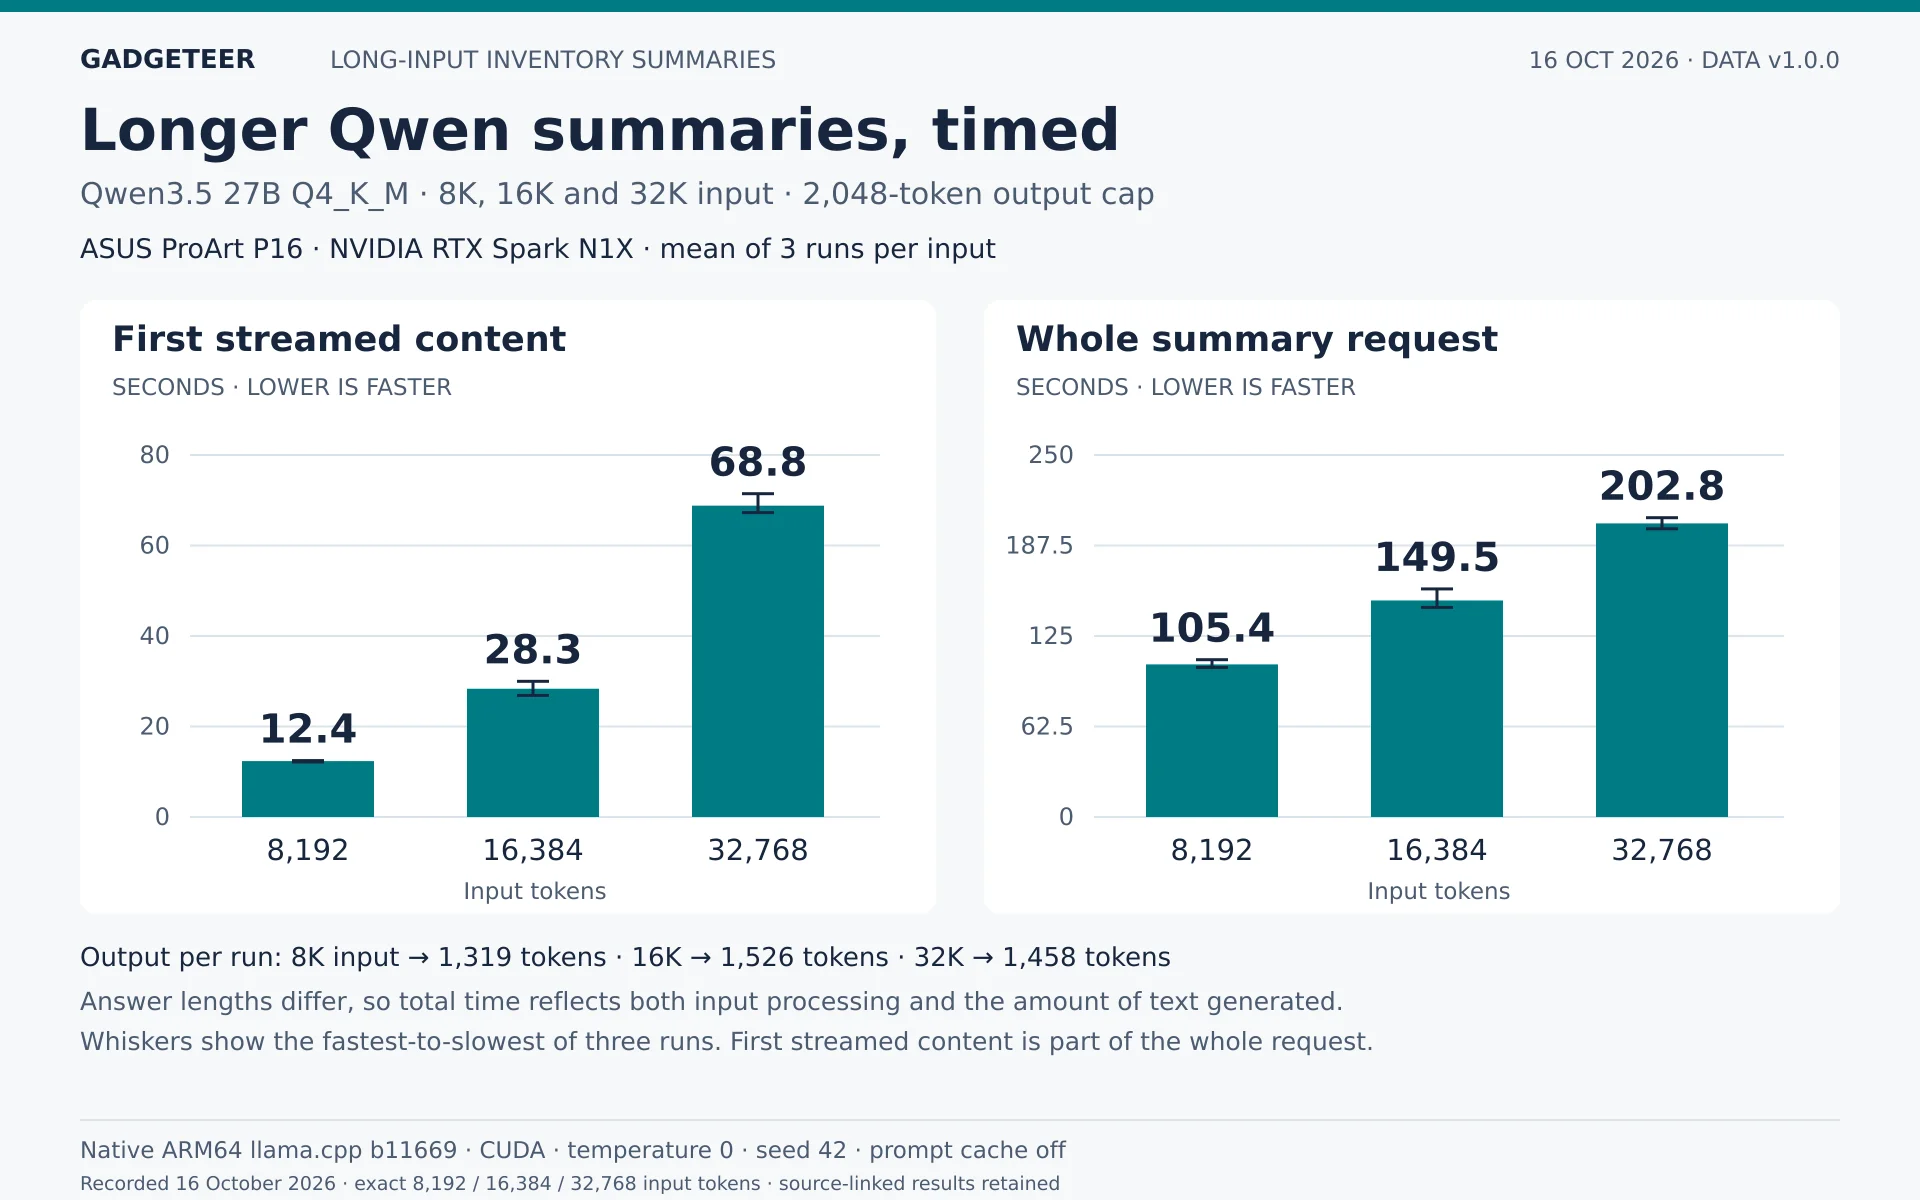
随后换用 Qwen3.5 27B Q4_K_M,跑了 30 次扩展执行,输入长度分别为 8,192、16,384 和 32,768 token,没有出现输入截断或空回答。另一项速度测试输入 8,192 token、最多生成 1,024 token:三次运行平均首响应 12.2 秒,整次请求 85.1 秒,生成速度平均 14.0 token/s。这三个数字分别回答等多久开始、多久完成、写得多快。
在允许更长回答时,库存摘要分别在三种输入长度下生成 1,319、1,526 和 1,458 token;平均完成时间从 105.4 秒升到 149.5 秒和 202.8 秒。由于回答长度不同,这些总时间不能单独拆出多出来的输入成本。
质量检查给出更细的区分:9 次信息抽取都正确返回了库存事实;另一个推理问题在 9 次重复中都返回 3,660 而不是 4,914。摘要把每个条目的计算做对了,但又加入了简报中没有的高端产品和库存充足假设。把输出限制在 1,024 token 时,有 3 份摘要写到一半被截断。风扇在测试中清晰可闻,但不烦人,任务结束后很快安静下来。
13 个模型的同一份简报
第二轮用同一份虚构产品简报测试 13 个本地模型,包括 NVIDIA Nemotron 3.5 Bolt 74B-A9B、4 个 PrismML Bonsai 2 模型,以及 8 个较早的 PrismML Binary 和 Ternary Bonsai 变体。任务很具体:抽取 10 项事实,把厂商电池宣称与实测结果分开,未知项留空。所有模型还要在简报和问题之间插入 60 条无关档案后再抽一次,并生成一段短文做速度测试;其中 7 个模型额外读取简报图片,并识别另一张图里的两个彩色形状。
虚构简报的主角是 FieldNote Mini 录音笔:重 180 克,厂商宣称最长 12 小时续航,售价 149 美元,2026 年 11 月 2 日上市,录音本地存储、云同步可选,未提供防水等级。评测备注写着:室内中等增益下实测 8 小时 40 分钟,仅 1 次试验,未测充电时间,送测机为石墨色。指令要求只输出指定 JSON 字段,未知用 null,不能把厂商宣称当成实测结果。
期望答案包括:FieldNote Mini;149 美元;2026-11-02;180 克;宣称 12 小时;实测 520 分钟;1 次试验;防水等级未知;充电时间未知;不要求云同步。8×60+40=520。
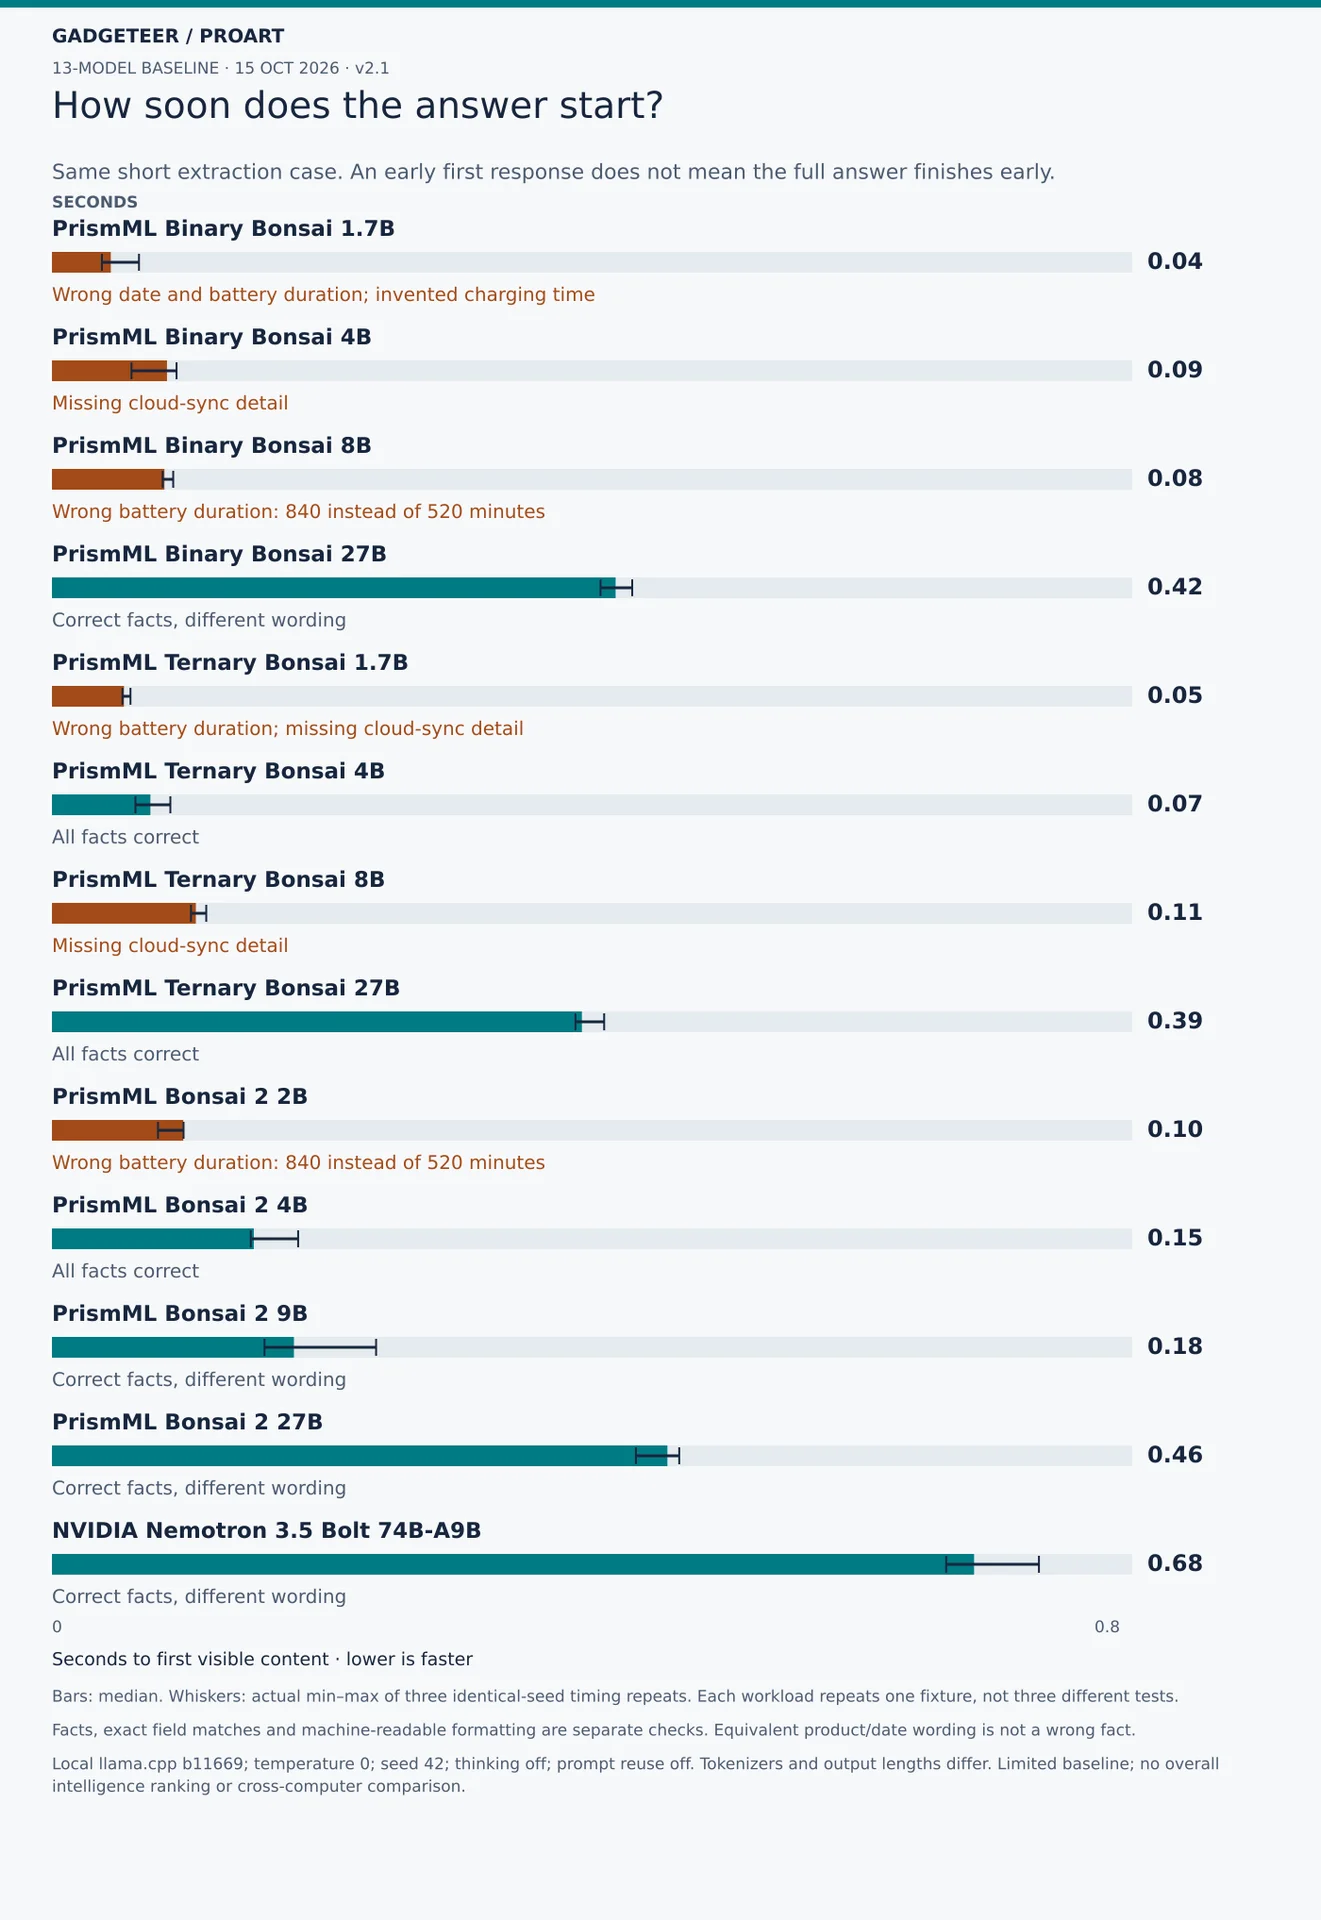
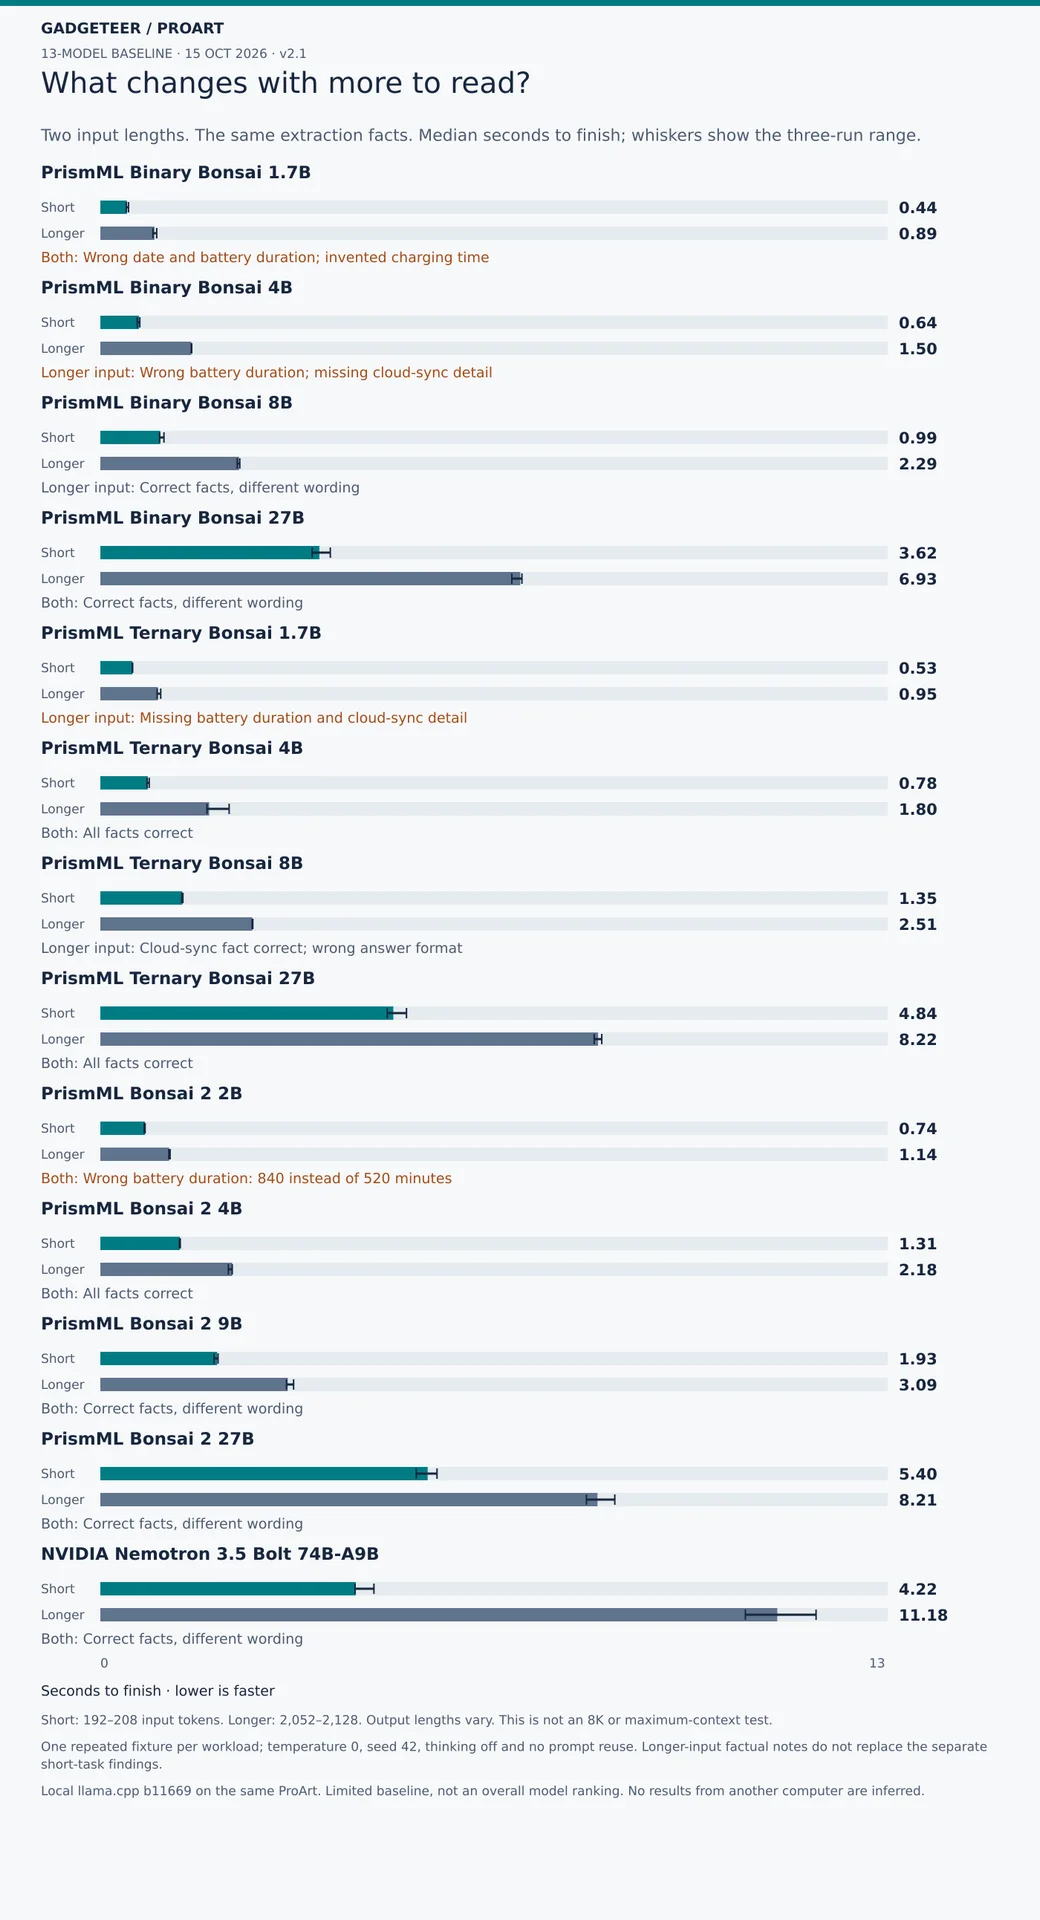
结果并不只是谁快。较早的 Binary Bonsai 1.7B 短抽取中位耗时 0.44 秒,却把日期写成 11 月 1 日、把电池改成 840 分钟、在未提供充电时间时填了 0,还漏掉云同步可选这一已知信息。Bonsai 2 2B 用时 0.74 秒,也返回了 840 分钟。较早的 Ternary Bonsai 4B 用 0.78 秒匹配全部 10 个字段,Bonsai 2 4B 用 1.31 秒做到;Bolt 用 4.22 秒返回正确事实,但产品写法和日期格式与模板不同。
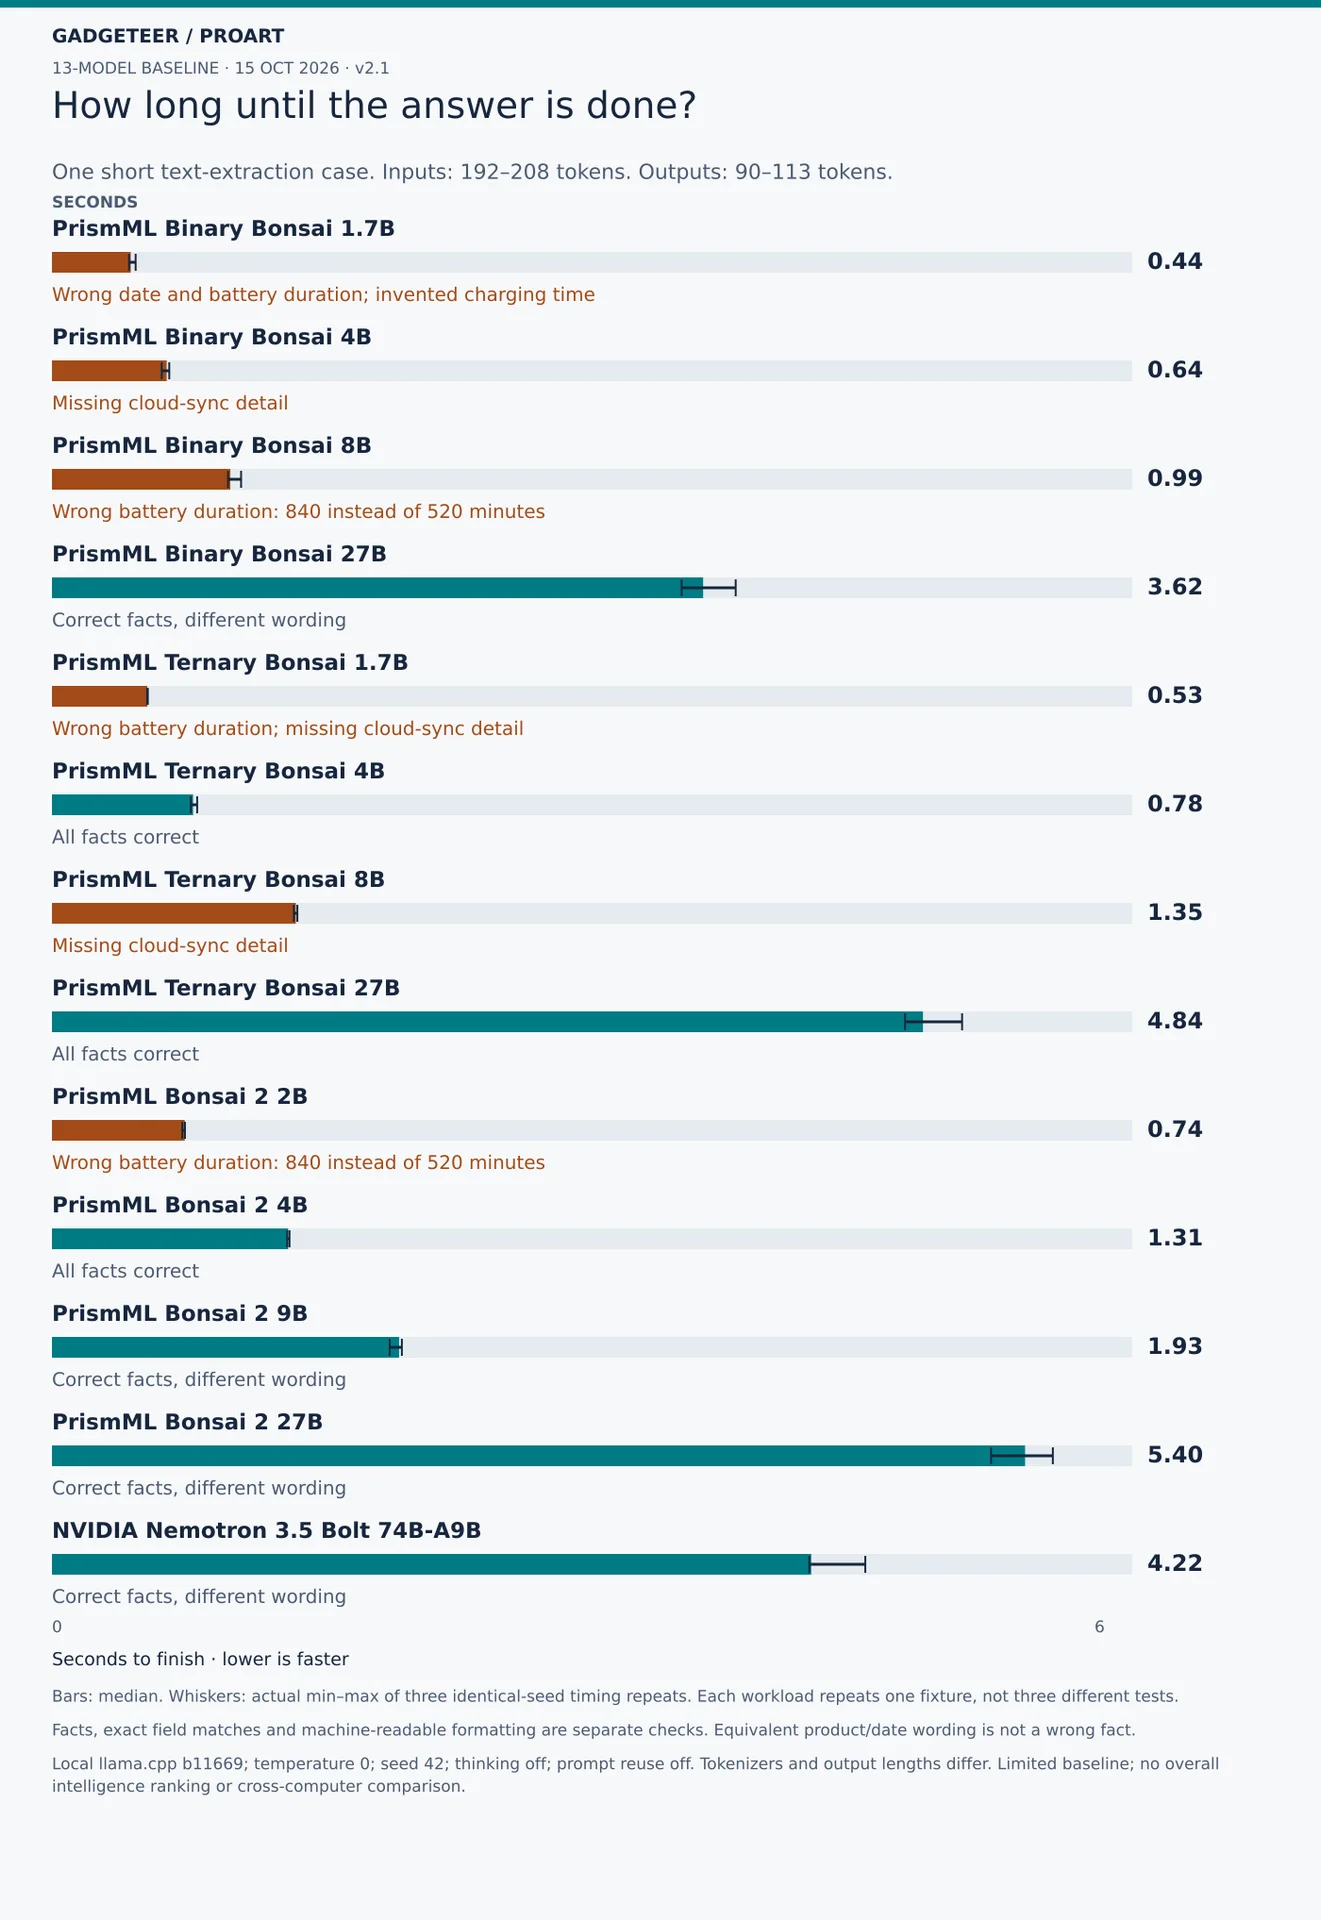
Bolt 写成“FieldNote Mini recorder”和“November 2, 2026”,与期望的“FieldNote Mini”和“2026-11-02”指的是同一产品和日期,所以精确字段命中是 8/10,而不是事实错误。另一个内容检查接受这两种等价写法,但不会把 840 分钟改成 520,也不会补上模型漏掉的事实。
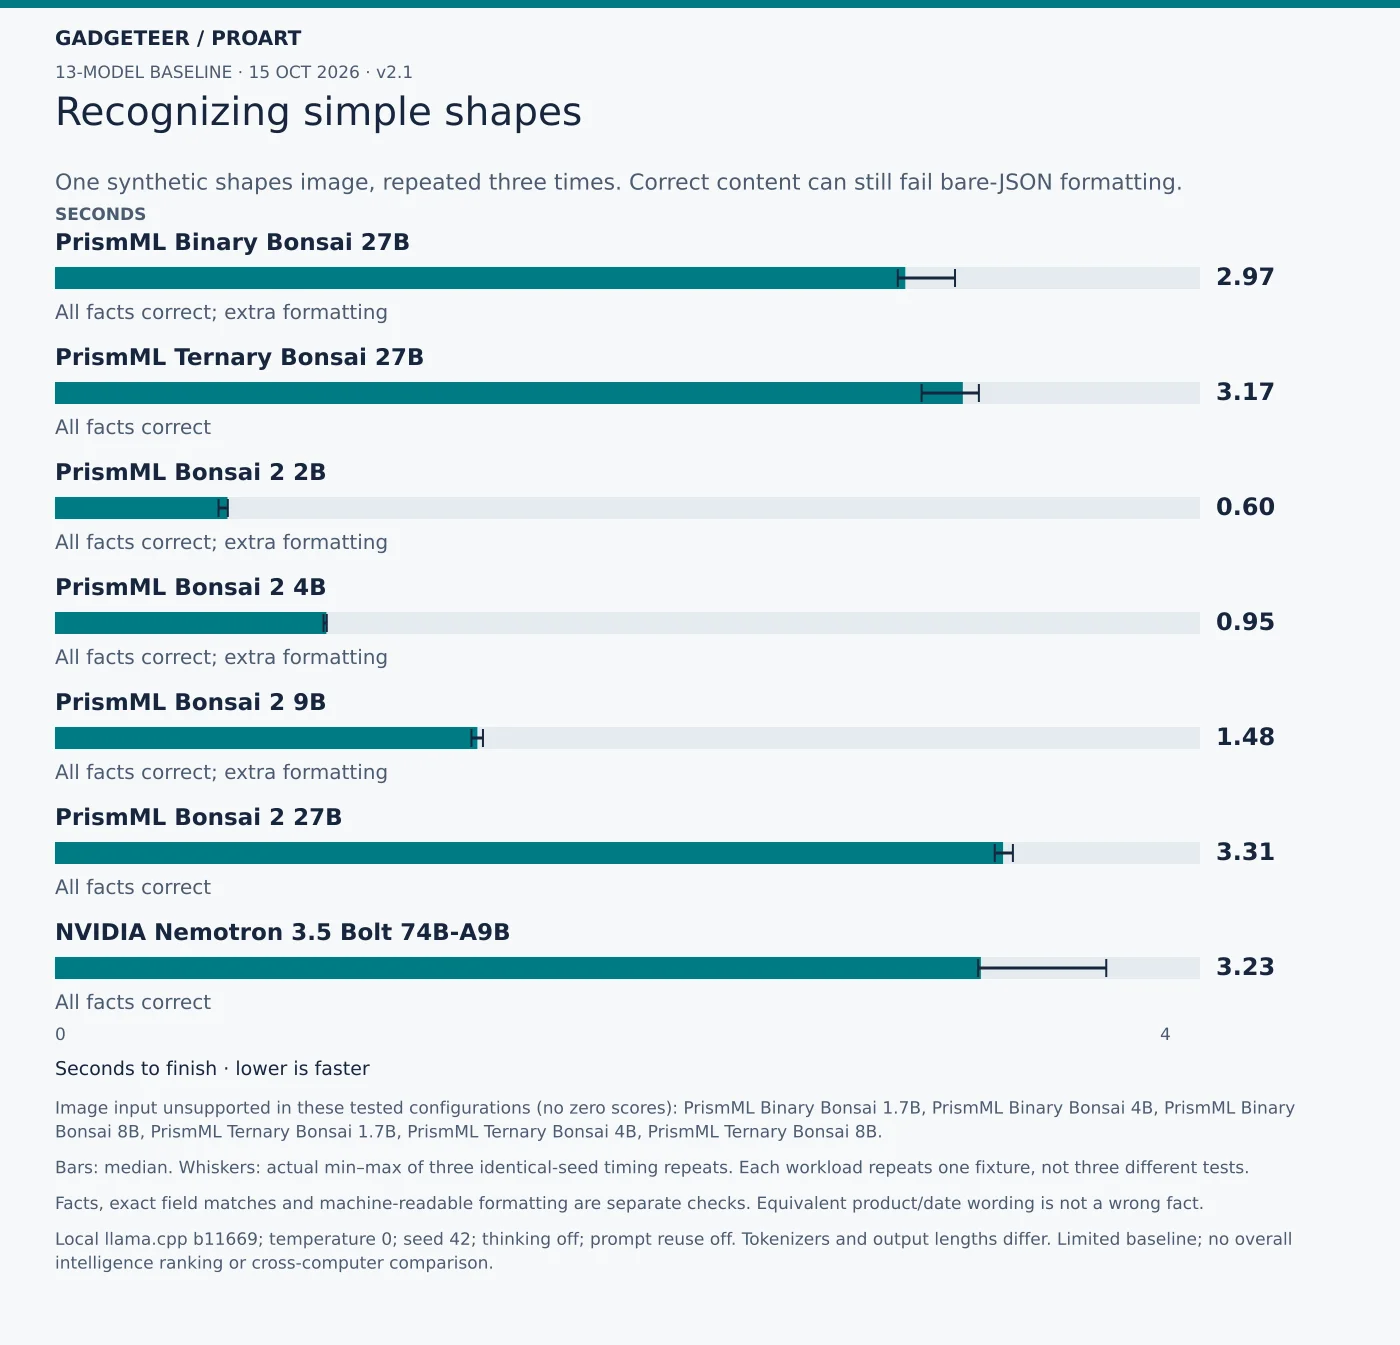
格式问题也会影响可用性:几次图像测试把 JSON 包在 Markdown 代码围栏里,人看着能读,严格 JSON 解析器却会失败。测试把格式失败、数值错误和缺失已知事实分开记录,而不是折成一个准确率。
速度有三个不同问题:首内容时间是从发送请求到第一段非空回答出现,包含输入处理和开始响应;完成时间是请求发出到响应流结束;生成速度是服务器解码阶段的 token/s。Bolt 的短抽取首内容中位 0.68 秒、4.22 秒完成;较早 Ternary 4B 为 0.073 秒和 0.78 秒。Bolt 返回 110 token,Ternary 4B 返回 90 token;同一个短问题经聊天模板格式化后,对 Bolt 是 208 输入 token,对 Bonsai 是 192。这就是完成时间、回答长度和 token 速率要一起看的原因。
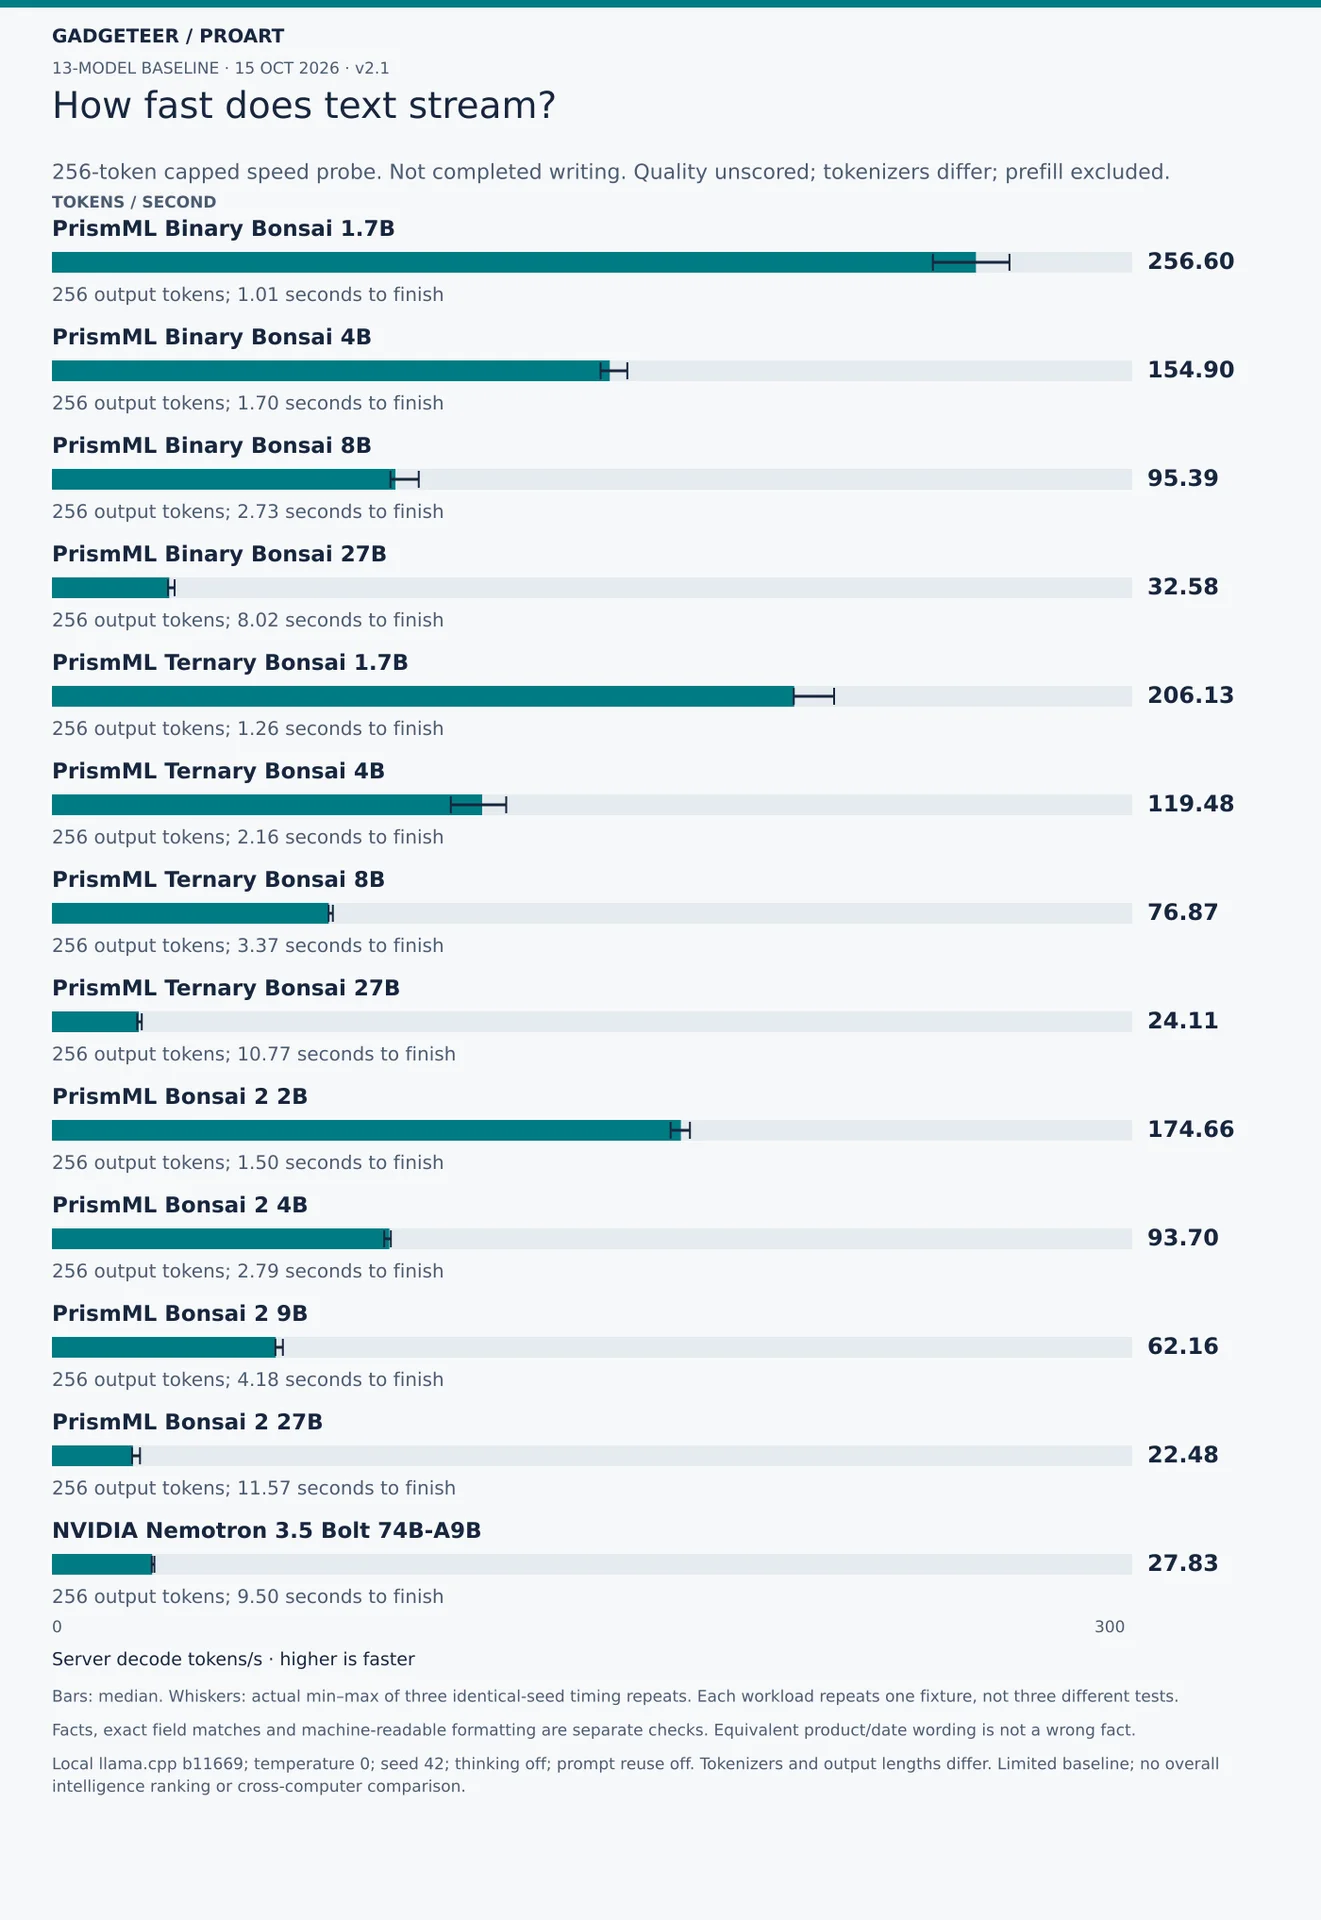
生成速度图使用另一条提示:一篇 800 词虚构现场报道,讲图书管理员整理想象中的旅行日志,每次故意在 256 个输出 token 停止。这个探针不评价写作质量。较早 Binary Bonsai 1.7B 中位 256.60 token/s,较早 Ternary Bonsai 4B 为 119.48,Bonsai 2 4B 为 93.70,Bolt 为 27.83。它们来自报道提示,不是十字段抽取回答。
长输入和图像输入
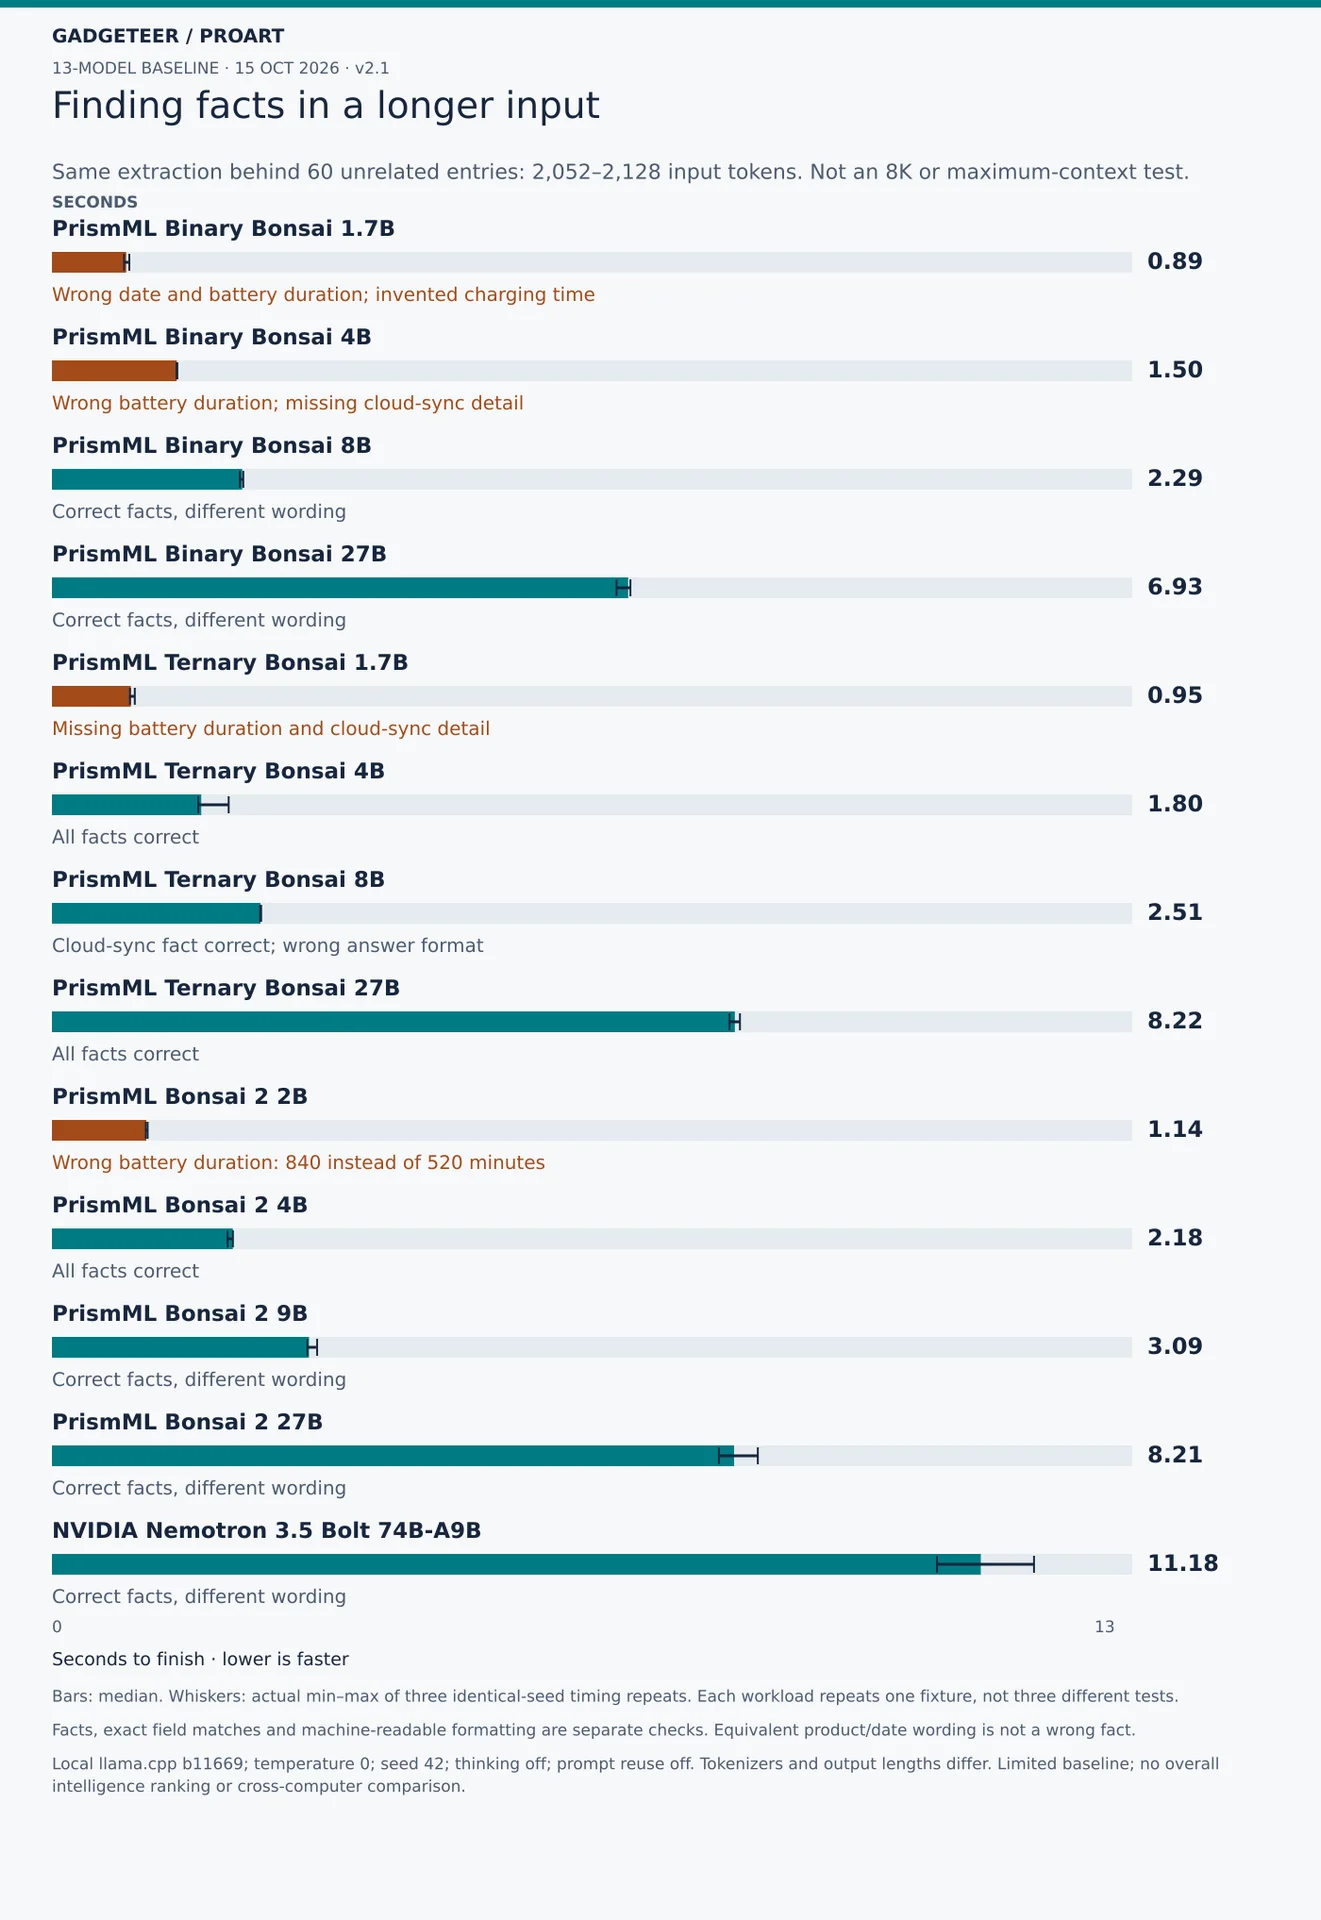
加入 60 条无关档案后,实际输入约为 2,052–2,128 token,而不是 8K;8,192 是配置的上下文上限。较早 Ternary Bonsai 4B 和 27B 仍匹配全部 10 个字段。短测试中返回 840 分钟的较早 Binary Bonsai 8B,在长输入下给出了正确的 520 分钟;较早 Binary Bonsai 4B 反而给出 484 分钟。相关事实没变,答案却变了,所以长材料里的抽取数字仍要回查原文。
图像输入又带来新问题。Bonsai 2 4B 和较早 Binary Bonsai 27B 都把 520 分钟读成 480,并且没保住云同步可选。多个模型把答案包进 Markdown。文本版做对,不代表同一模型读图片版也能做对;更大的模型也不能免疫。
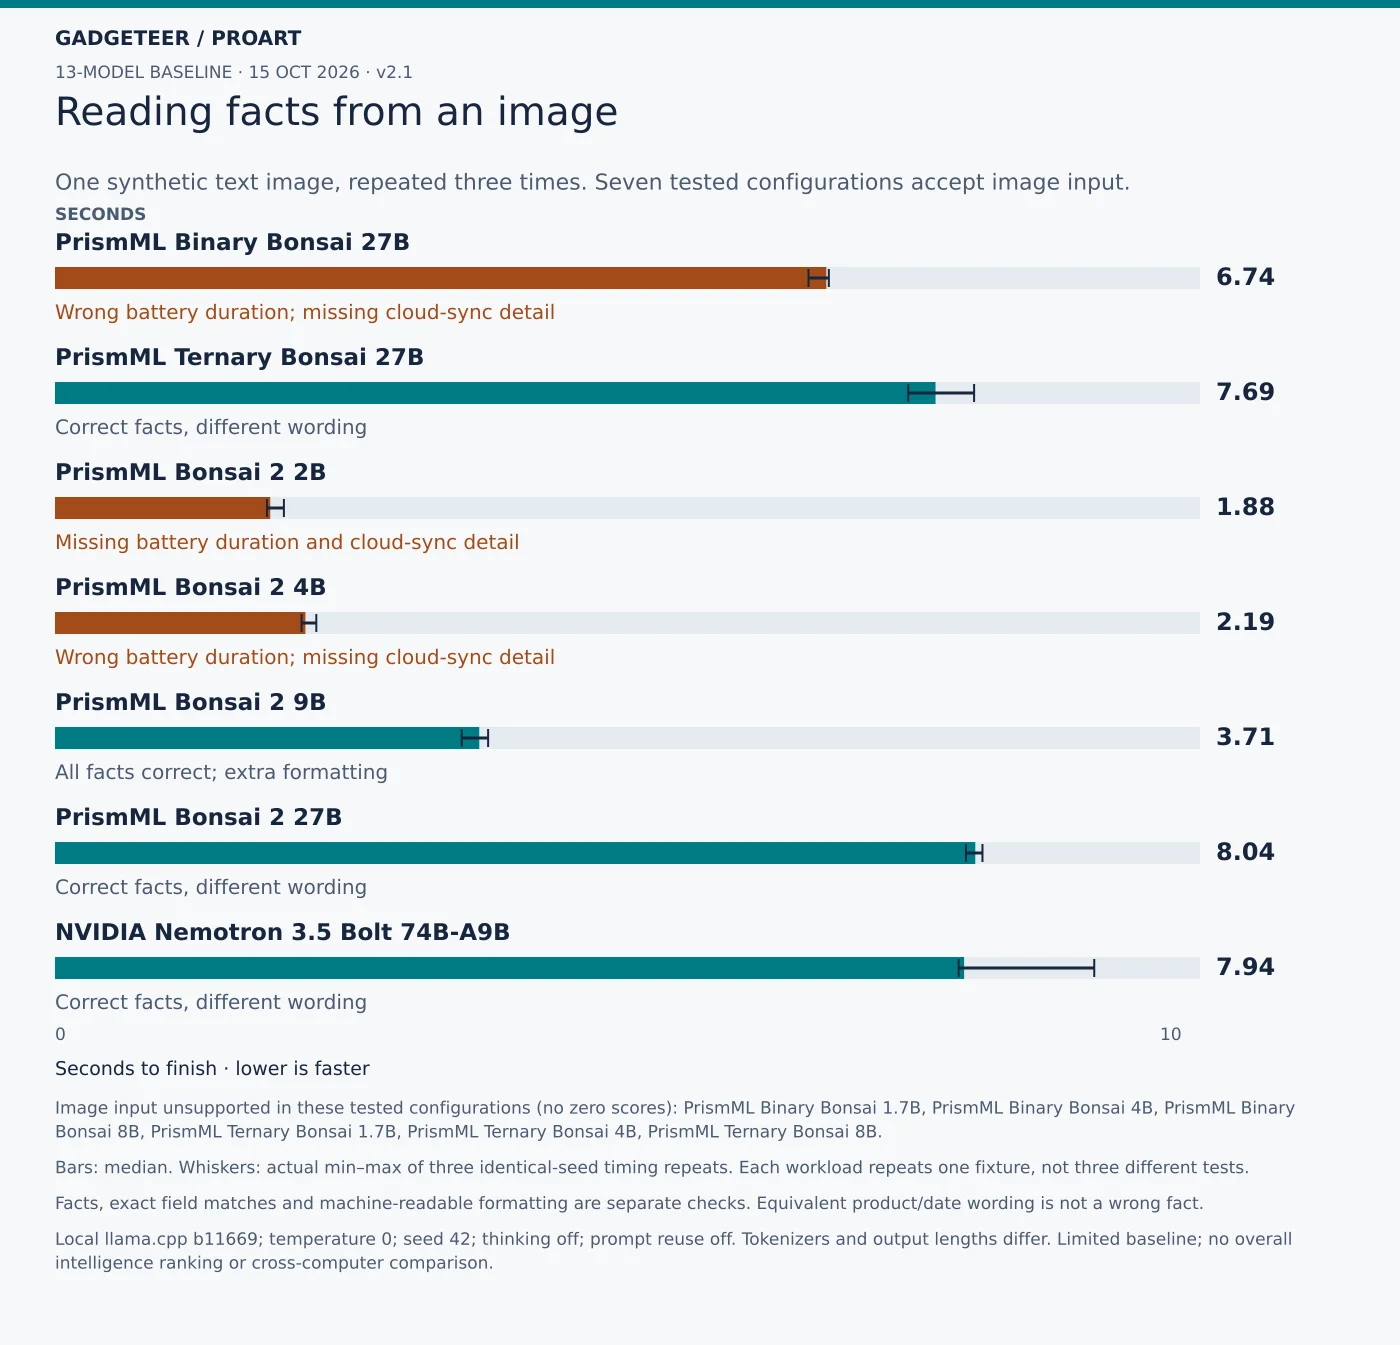
第二张图故意很简单:左边红圆、右边蓝方块。模型要说出形状、颜色、位置和总数。7 个配置支持这项测试;6 个较早 Binary/Ternary Bonsai 配置在测试环境下不支持图像输入,原文没有给它们编造分数。
测试设置与边界
- 测试量:文本和图像任务共 159 次计时响应、21 次就绪检查。每个工作负载用同一输入跑 3 次,温度 0、种子 42;图中给中位数和最快到最慢范围,重复 3 次展示的是计时波动,不是 3 个不同准确率案例。
- 计时口径:模型加载完毕并通过就绪请求后才开始计时,加载时间不计入。提示复用关闭,每次请求报告复用的提示 token 为 0;加载期间操作系统文件缓存未受控。聊天格式化和单独的分词器检查在计时前完成。
- 运行环境:日常后台应用保持打开,Windows 使用记录的 Standard 电源方案,测试顺序未随机化。小幅计时差异不应承载大结论。
- 技术栈:同一时间只加载一个模型、一个请求槽;通过聊天模板关闭思考,不使用推测式草稿模型。Windows ARM64、CUDA 13.4、llama.cpp b11669(提交 620d2225c),8,192 token 上下文,q8_0 键值缓存,flash attention,批大小 512、微批 128;每次图像运行使用匹配的投影器。
另外,Llama 3.3 70B 的一次尝试在加载阶段停止,安全监控检测到 Windows 提交余量不足;它没有生成答案,因此没有这项配置的速度或质量结果。换一套设置可能不同。
本地 AI 工作流的现实结论
- 短任务:一些较小模型在短抽取里不到 2 秒返回所需事实,适合从简报里先拉细节。
- 长任务:Qwen 在 8K 输入速度测试中约 12 秒开始回答,生成 1,024 token 总共约 85 秒;完整 32K 输入摘要约 3.4 分钟。这类任务适合发出去再回来收。
- 仍要核对:Qwen 把库存字段和单项计算做对了,却在另一项任务中加入业务假设并算错合计。我会把它的输出当草稿对照原始材料,不会让它管理发票或无人监督地执行动作。
GPU、CPU 与 SSD 初测
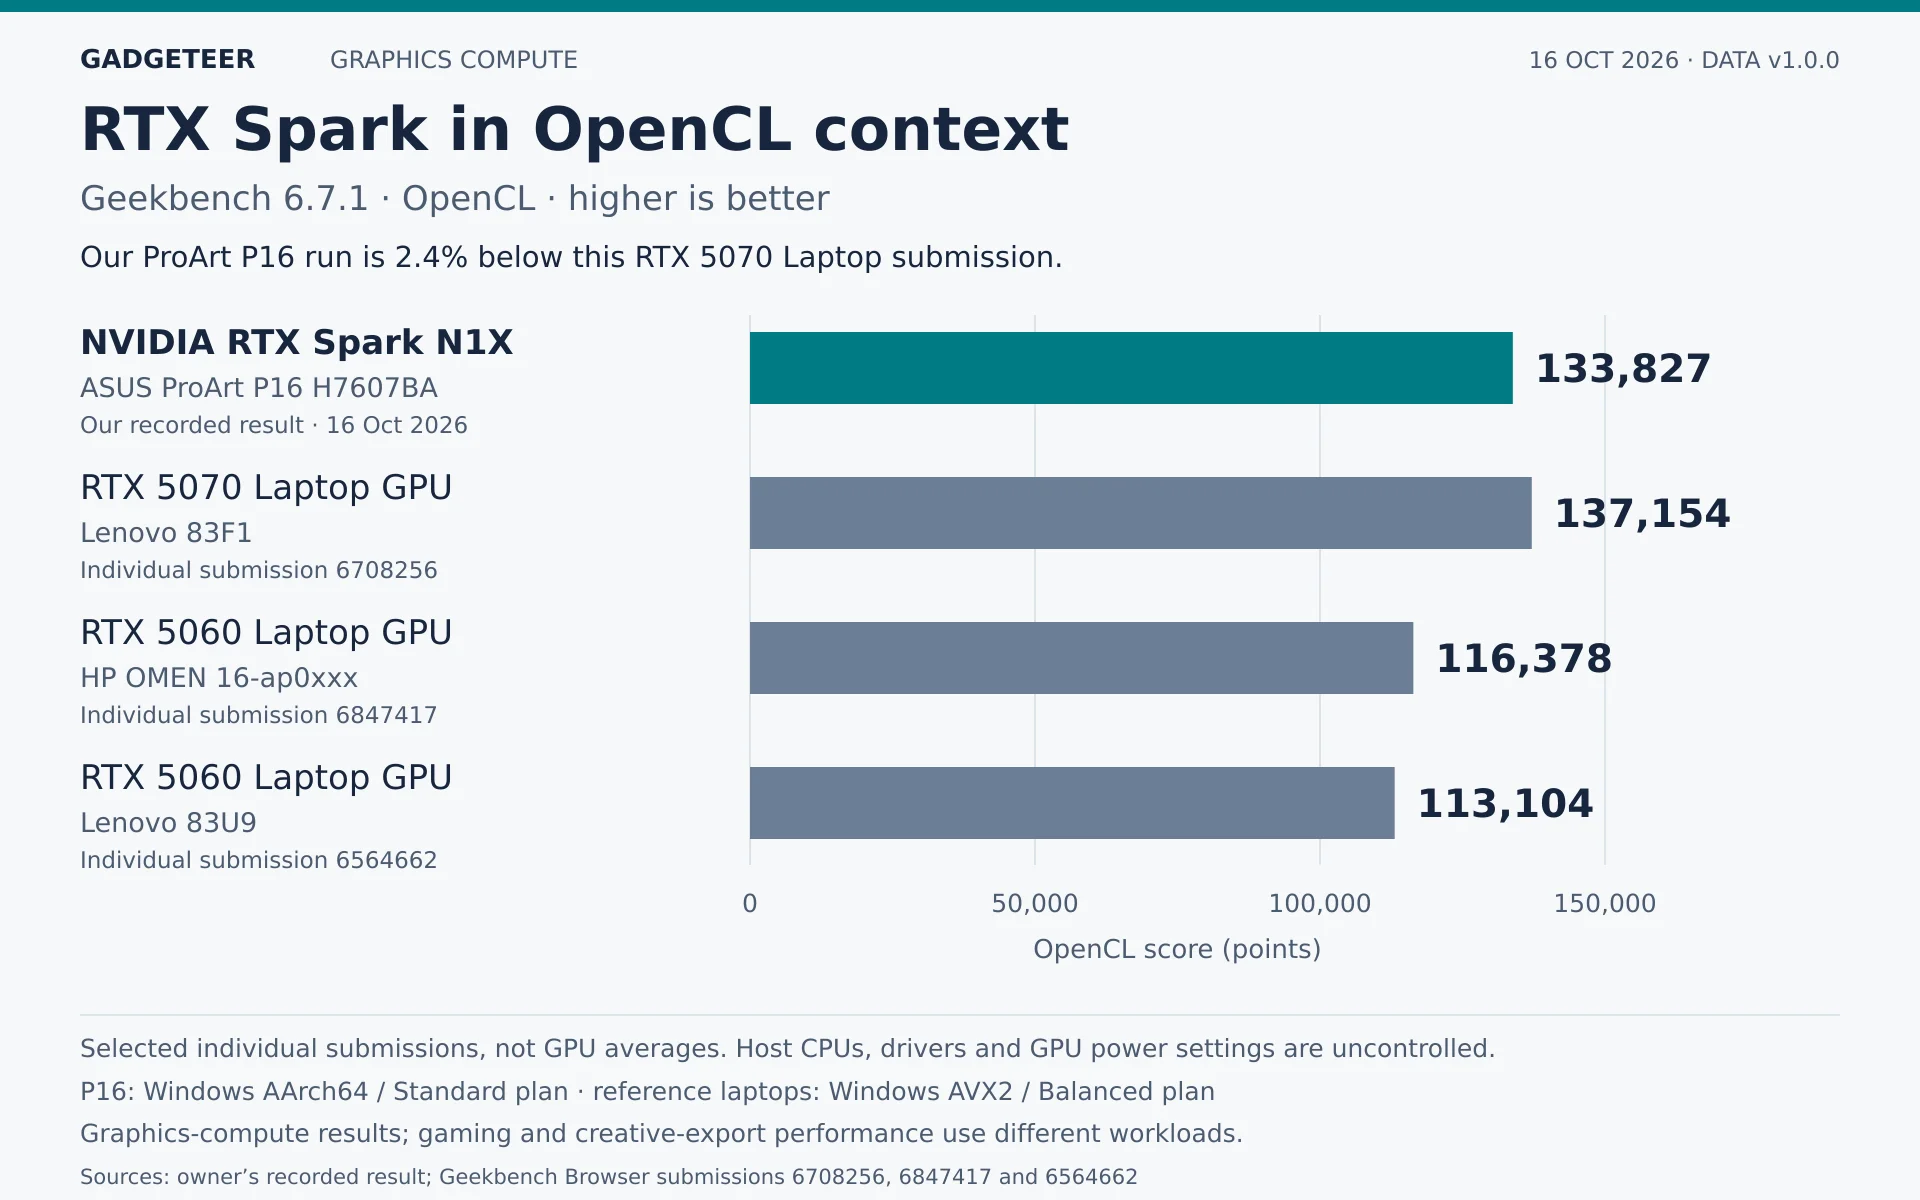
Geekbench 6.7.1 OpenCL 图形计算得分 133,827,比一份 RTX 5070 Laptop 的 137,154 低 2.4%,比两份 RTX 5060 Laptop 的 116,378 和 113,104 高约 15–18%。这些是同一版本 Geekbench 和 OpenCL 测试的个别提交,笔记本功耗、驱动和处理器都未受控,只能提供背景,不能推出相同游戏帧率、光追或导出时间。
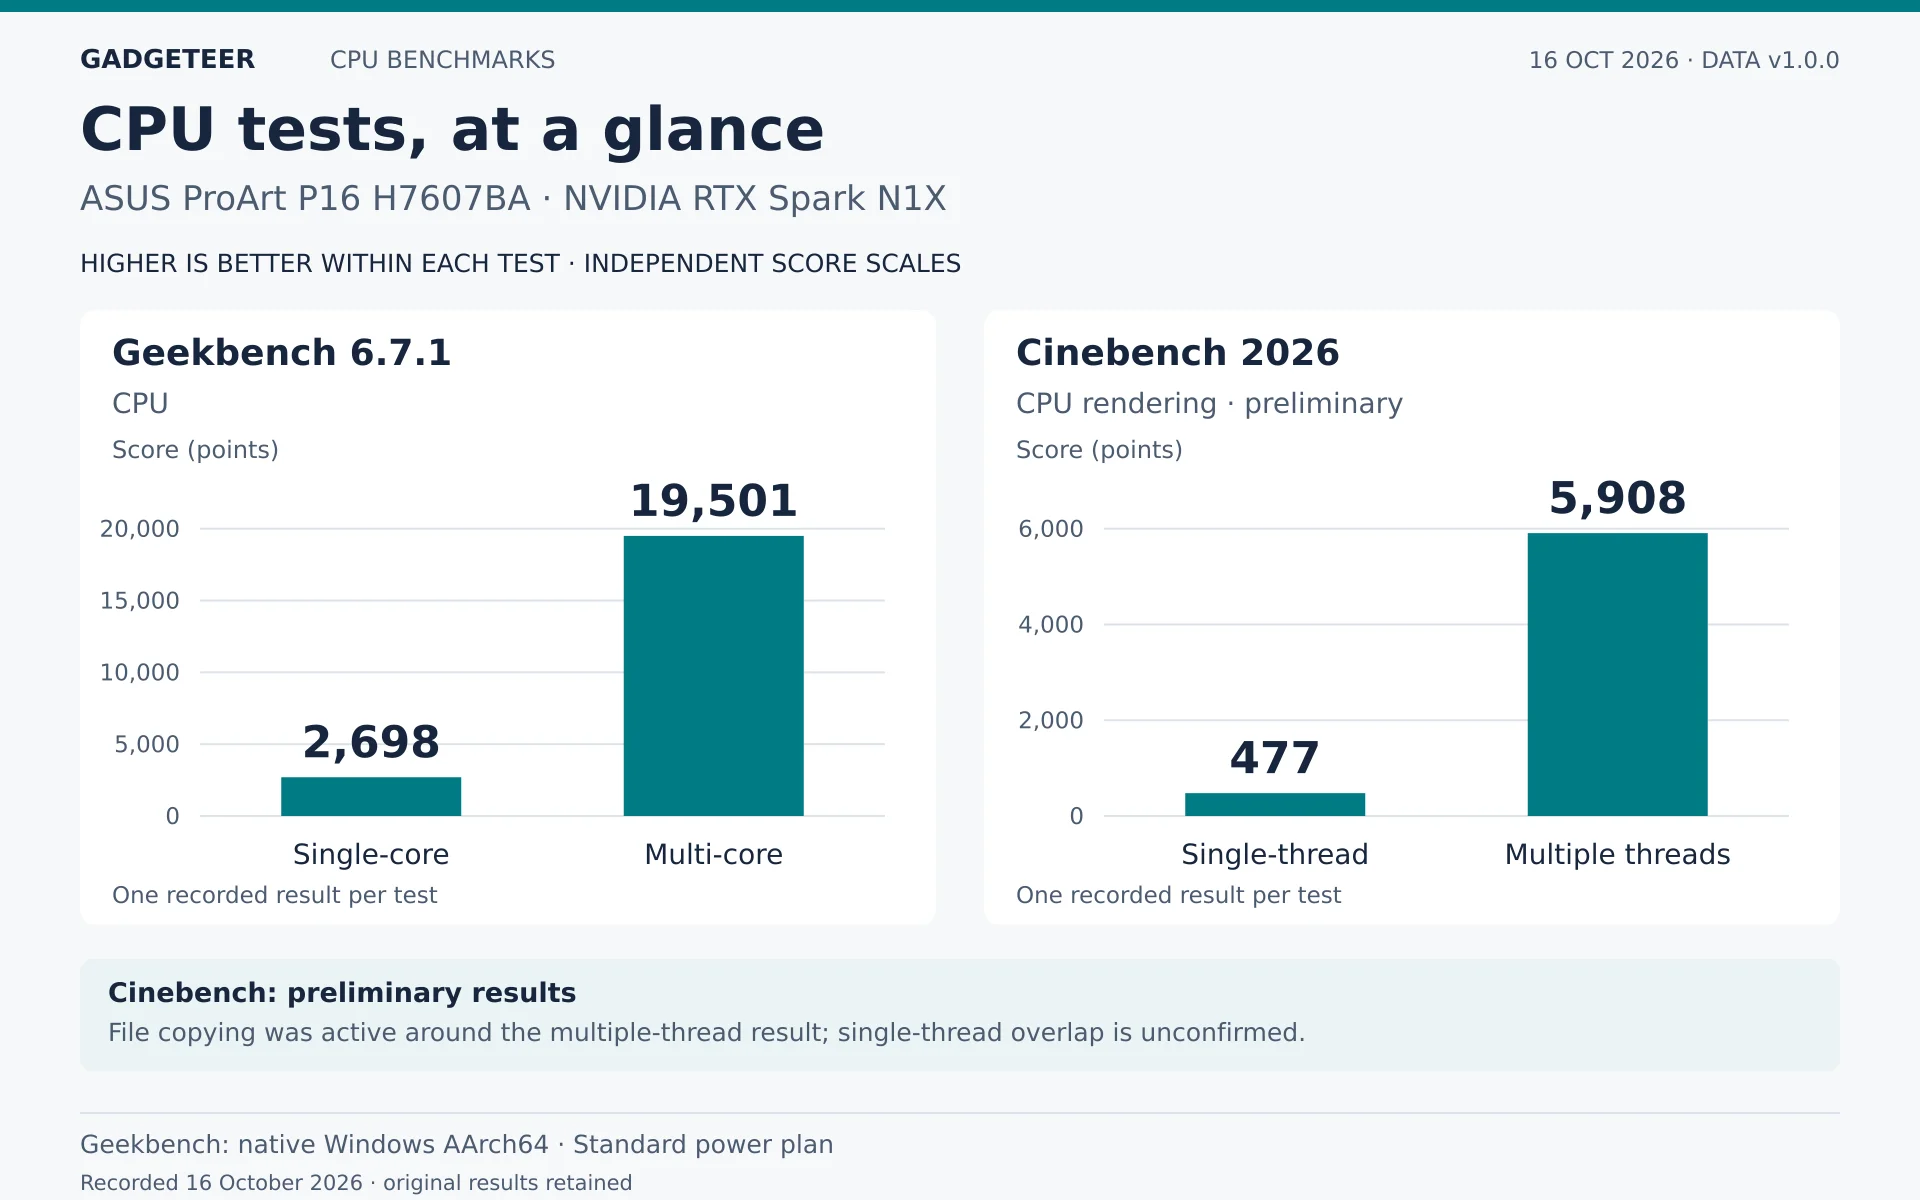
CPU 方面,Geekbench 6.7.1 Windows ARM64 得到单核 2,698、多核 19,501,电源计划为 Standard。Cinebench 2026 为单线程 477、多线程 5,908,显示 12.39× 比率;多线程结果附近仍有文件复制活动,单线程是否重叠尚未确认,所以这是初步结果。
作为参照,三份个别提交:Surface Laptop 7(Snapdragon X Elite)多核 14,158,ROG Zephyrus G16(Ryzen AI 9 HX 370)15,583,Dell XPS 16(Core Ultra X7 358H)16,462。ProArt 的多核比这些特定运行高约 18–38%,单核低约 5–8%。一台 16 英寸 M5 Pro MacBook Pro 提交达到单核 4,279、多核 28,686,两项都领先这次 ProArt。不同功耗和平台构建下,这些只是参考点,不是受控横评或型号平均值。
单项任务比总分更有信息量:相对那台 Zephyrus,ProArt 的多核 Clang 编译得分高约 37%,但对象移除得分低约 27%。总分更高不等于每个照片或视频操作都更快,实际创作应用仍要单独计时。
SSD 用 CrystalDiskMark 9.0.3 ARM64、3 次、1 GiB 测试文件:队列顺序读取 7,330.57 MB/s、写入 6,511.18 MB/s;只有一个顺序请求未完成时,分别为 2,296.03 MB/s 和 1,878.81 MB/s。4K Q32T1 读取 183.83 MB/s、写入 335.55 MB/s;Q1T1 为 42.34 MB/s 和 86.44 MB/s。测 SSD 时我暂停了后台文件复制,尚未测试长时间大文件持续传输是否保持速度。
接下来
屏幕和接口已经让 P16 成为一台愿意每天打开的机器,但本地 AI 的价值不在能跑,而在哪类任务可以信。接下来我会带着它去奥斯汀 F1 周末拍照片和视频,看看离开桌面的编辑流程是否成立;也会继续跟踪这些模型在更有后果的工作中的表现。弱建议可以随手丢掉,错总数和代我执行的动作不行。


讨论
0 条评论